IO
@IO
IO
@IO
-
 我有魔芋爽 Post #103
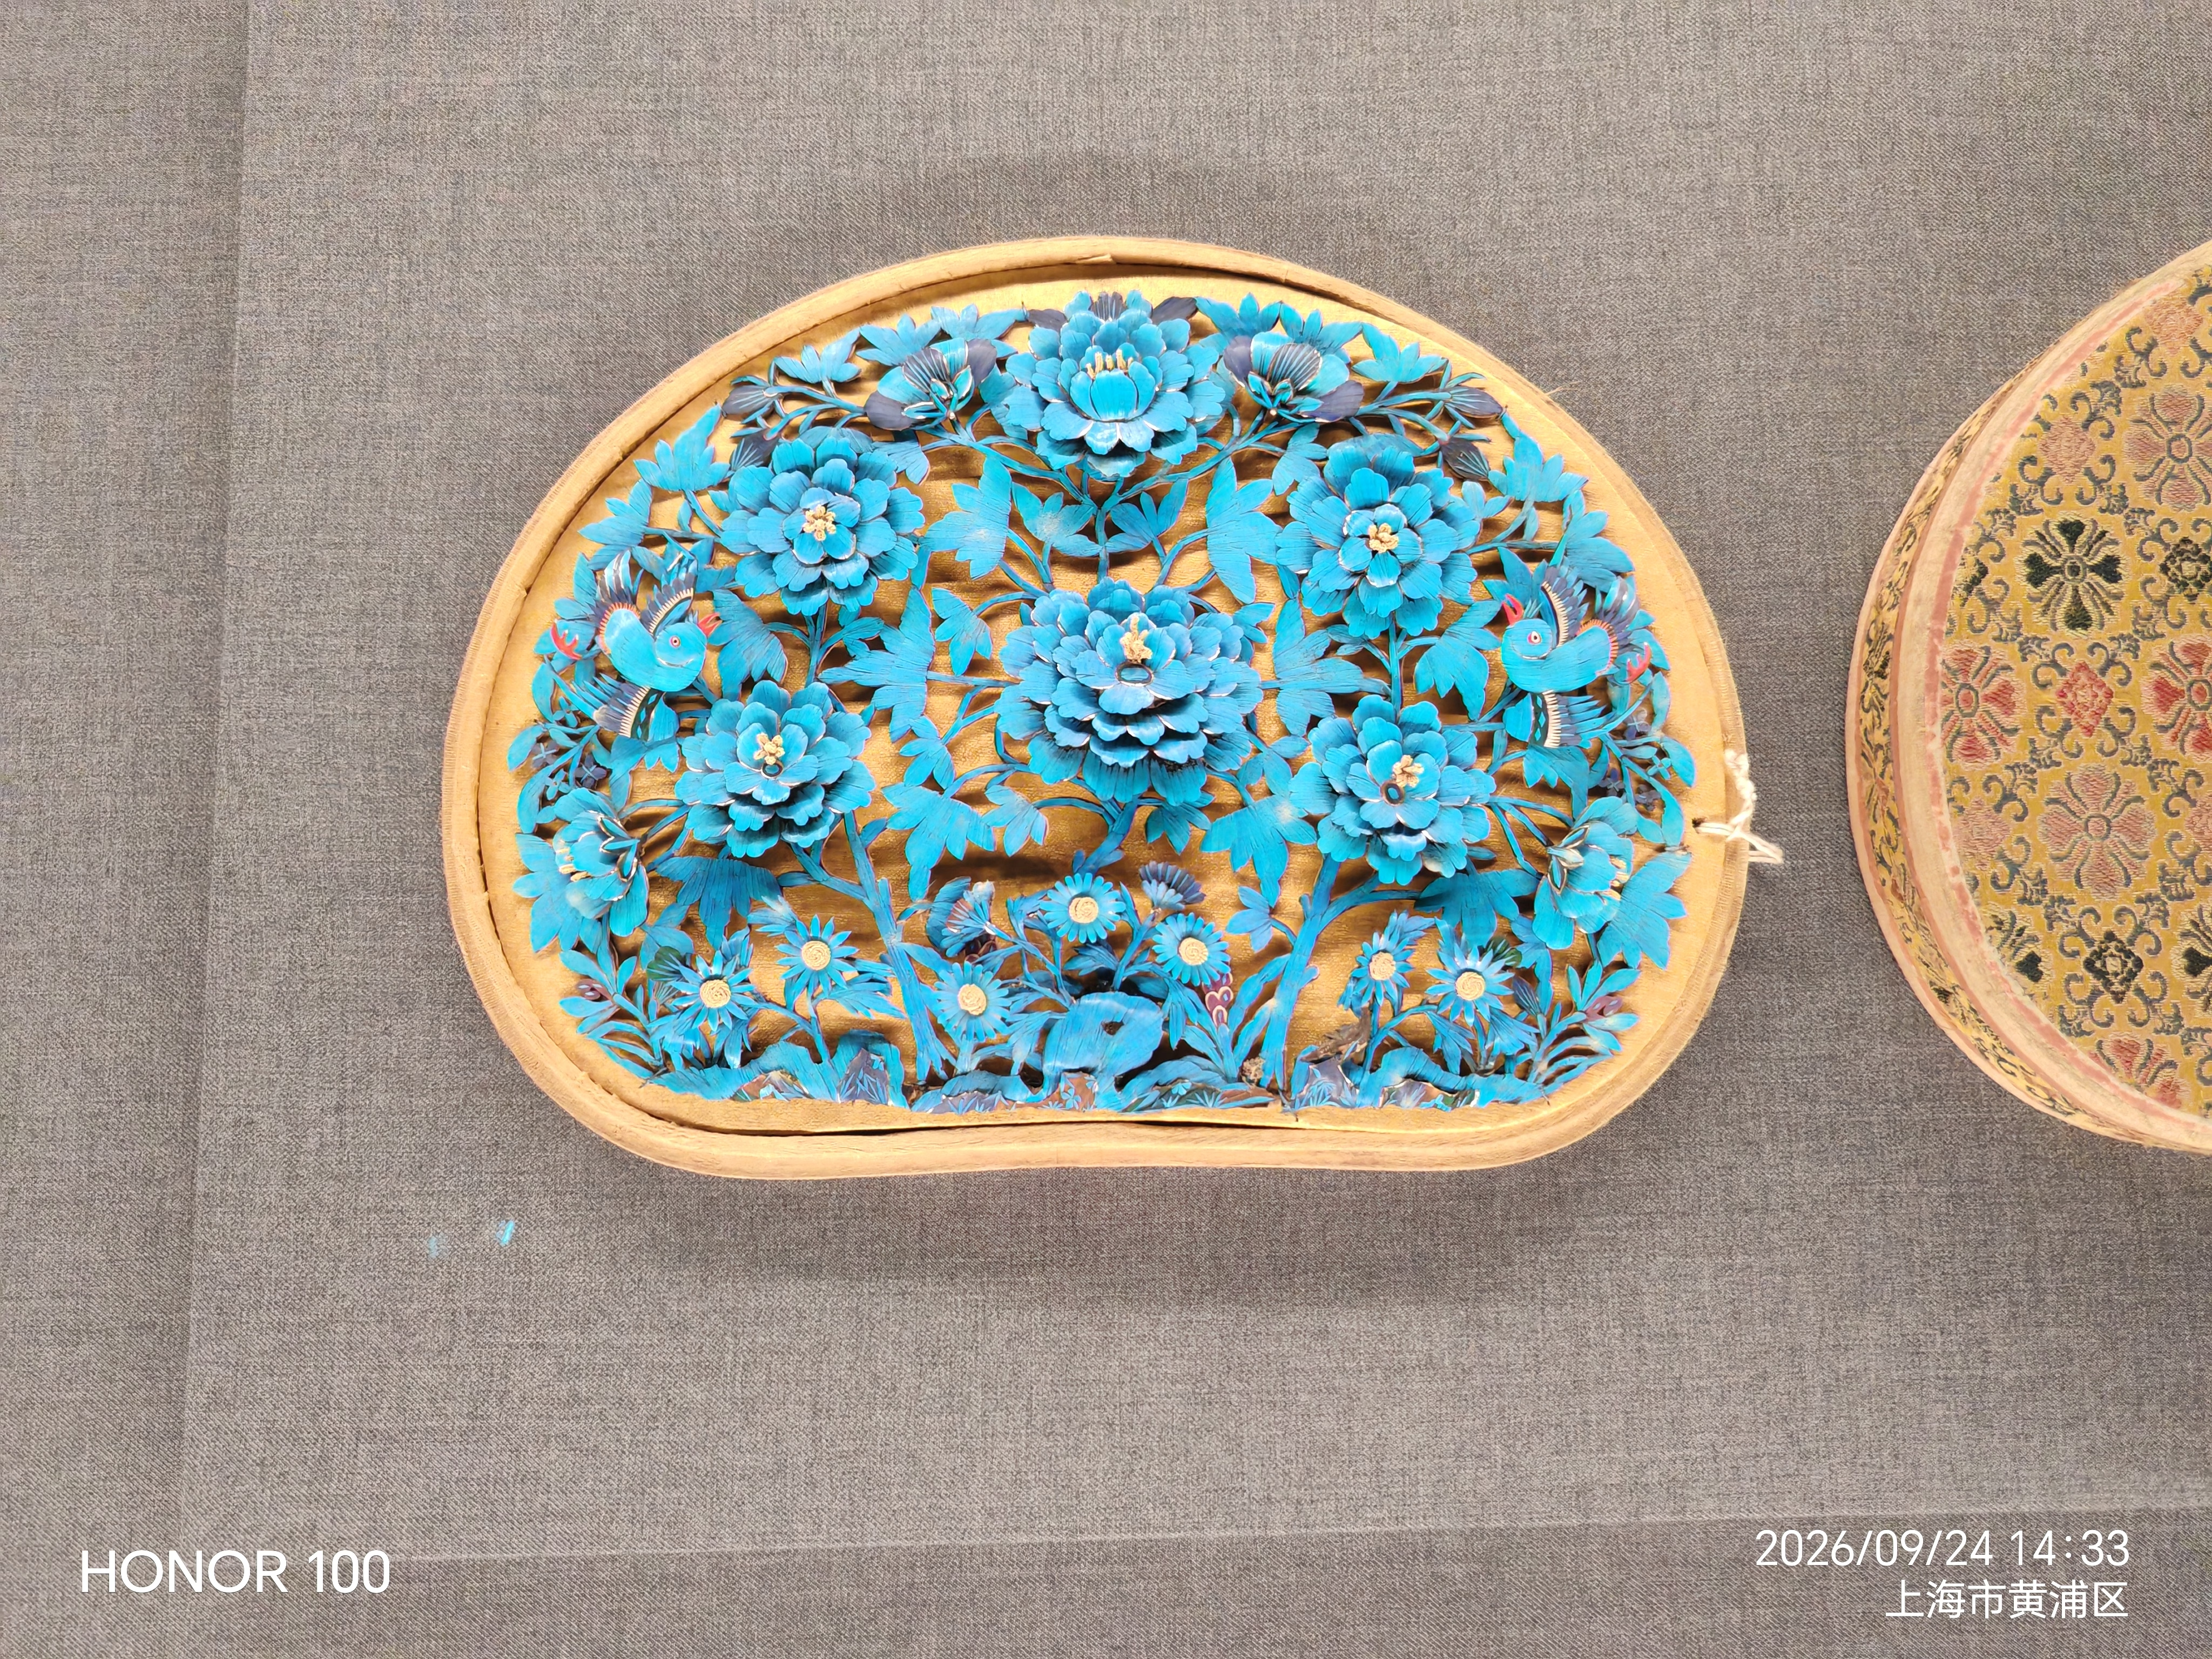
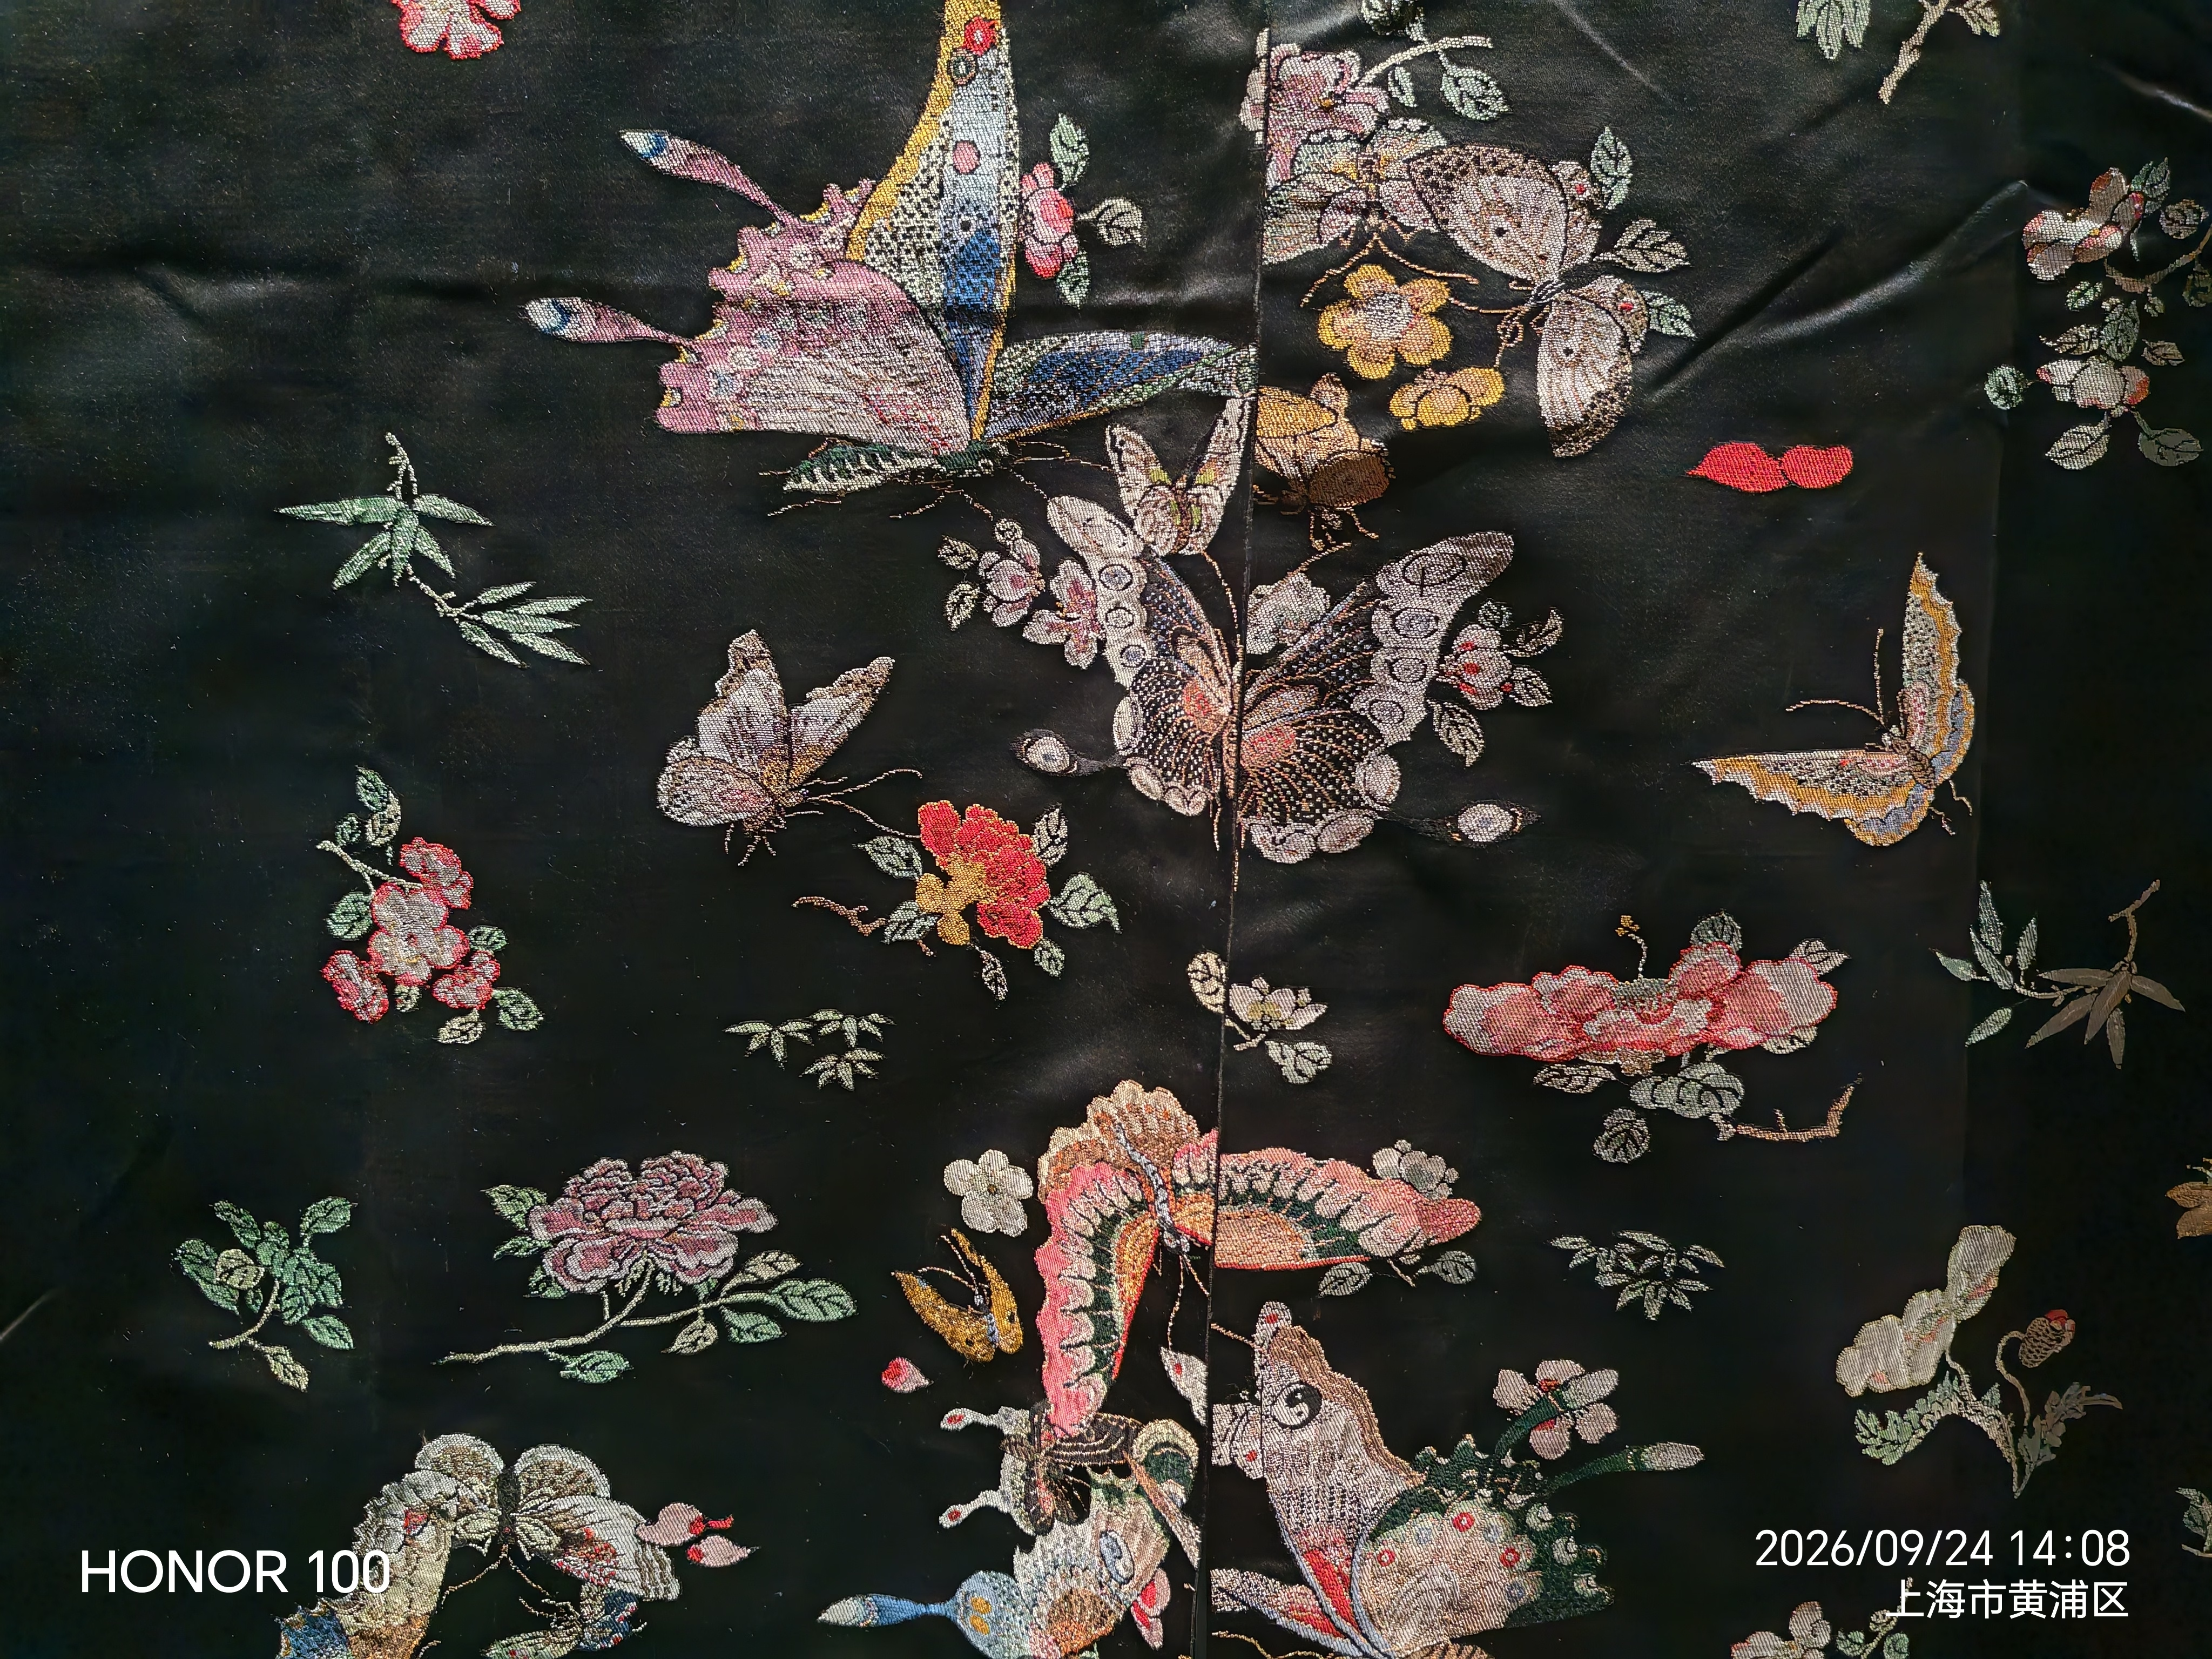
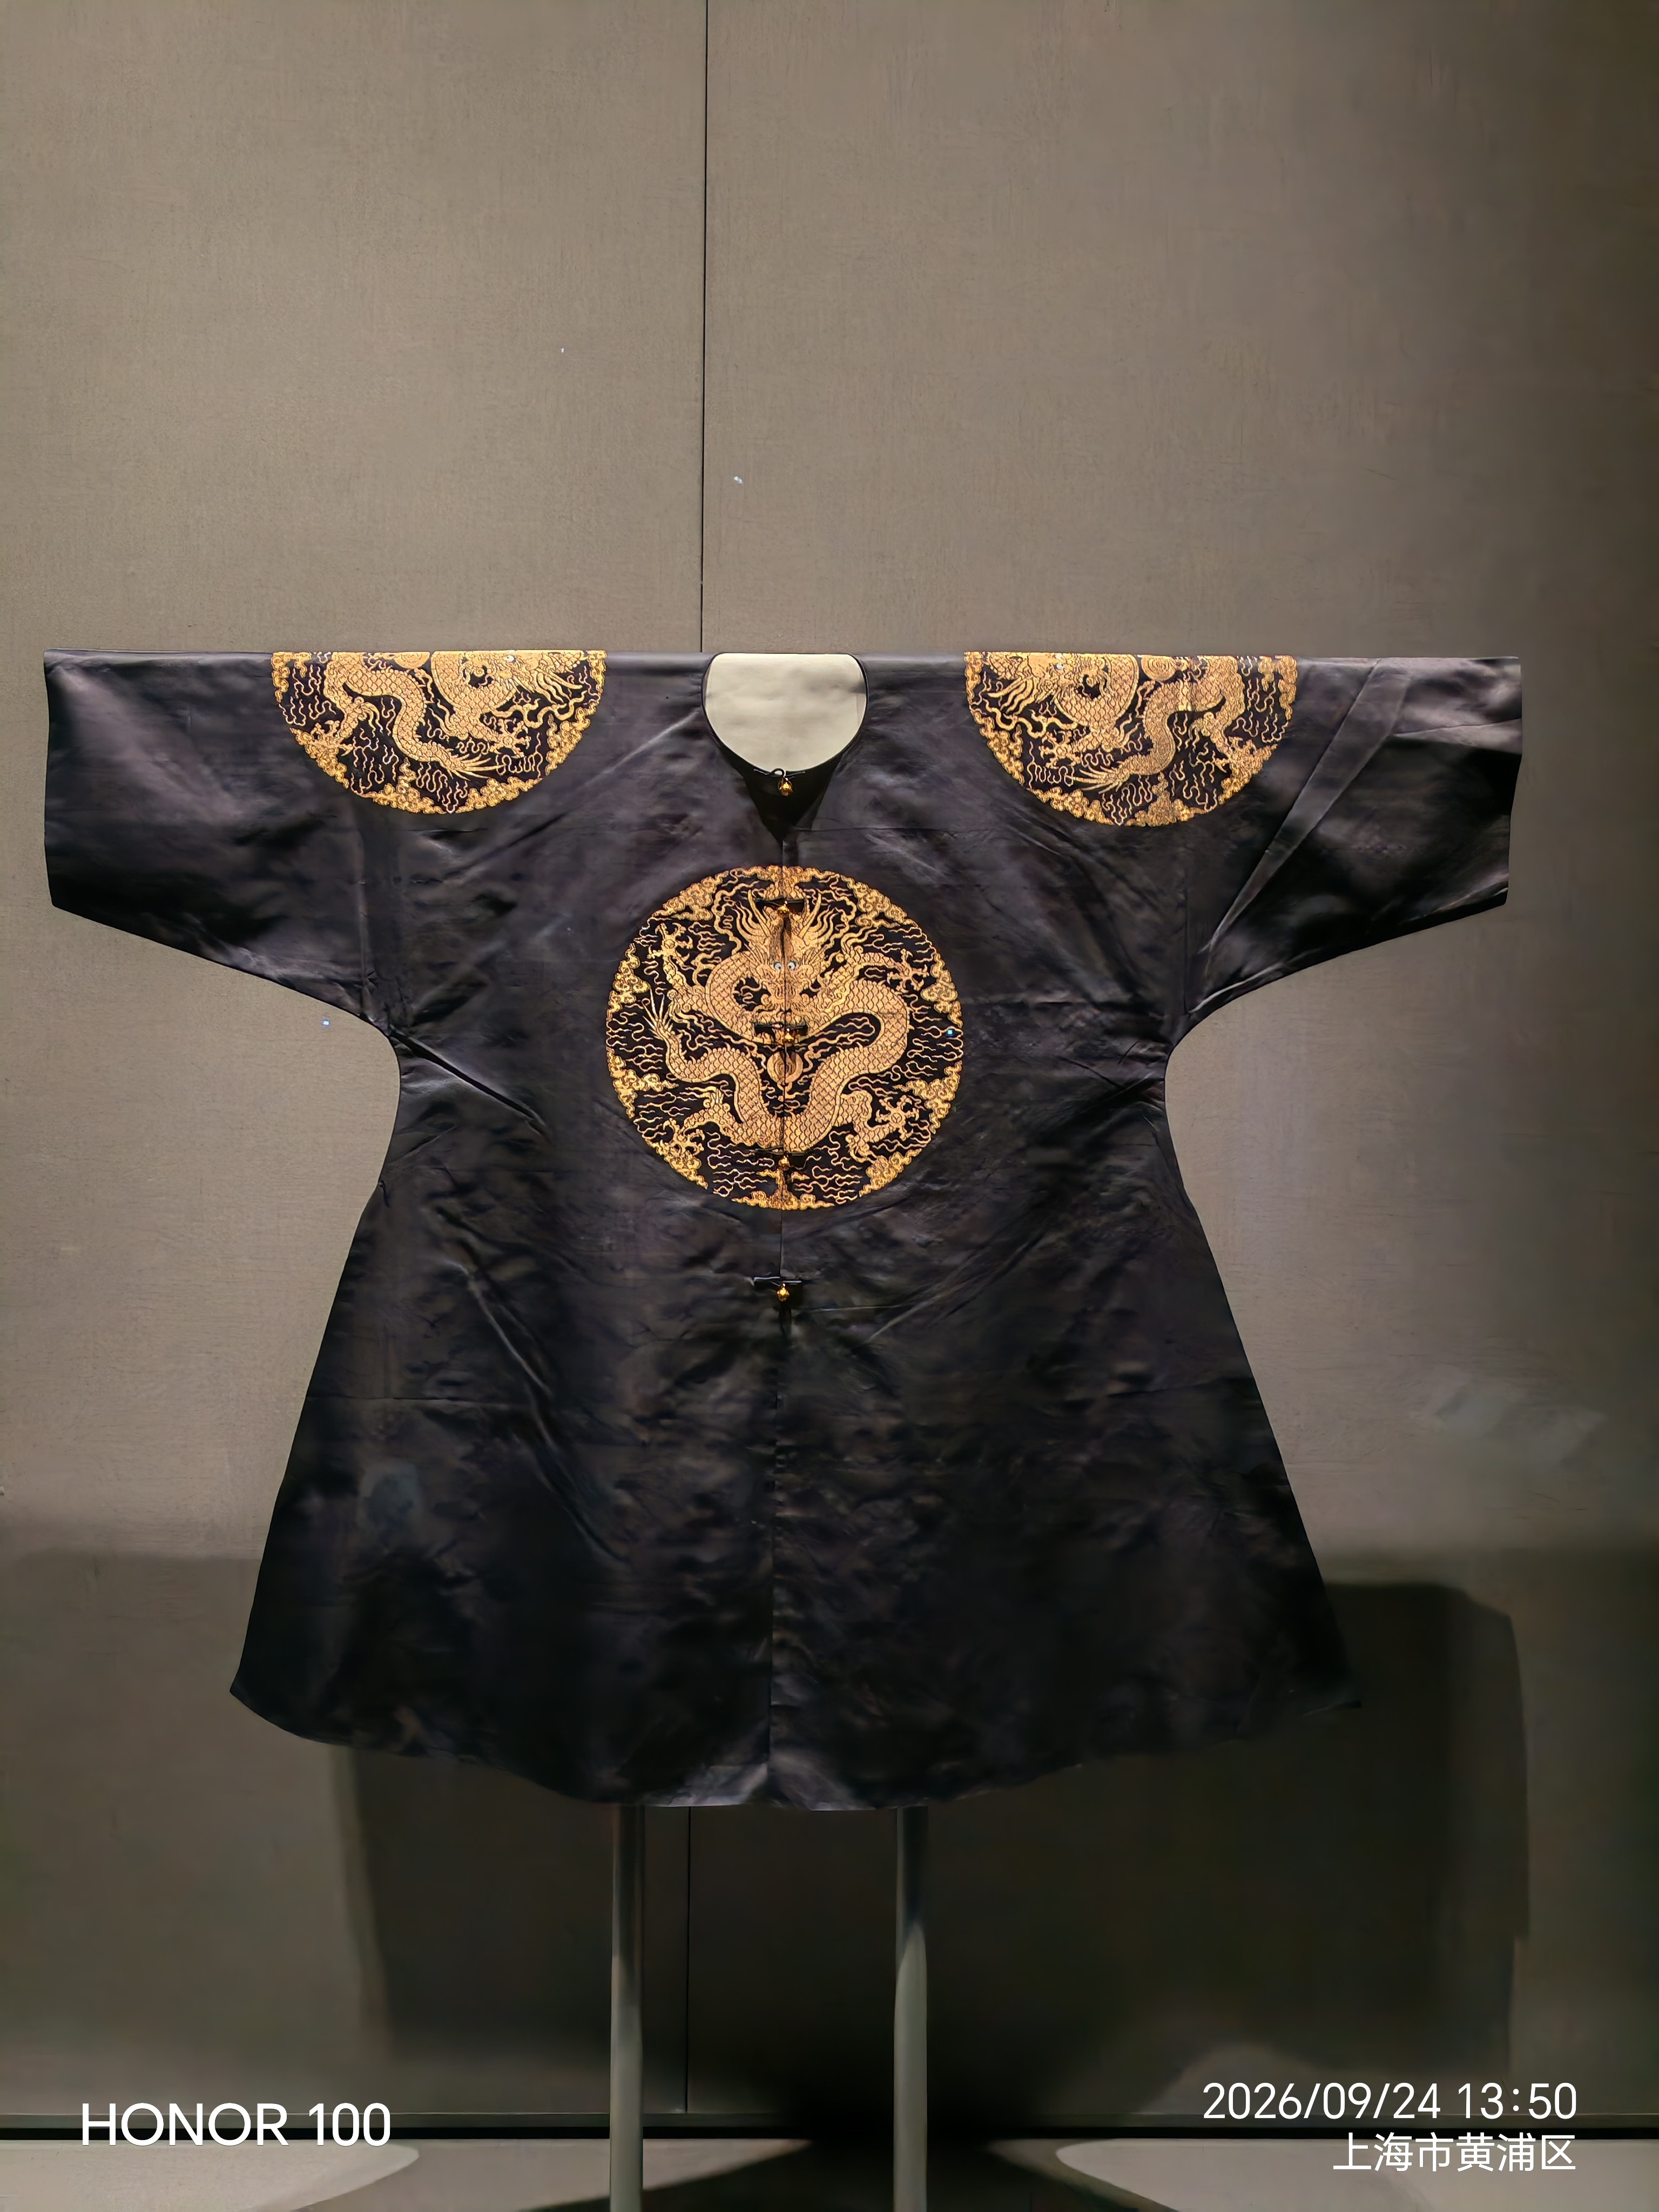
故宫清代帝后服饰展——最不白来的一集!
图片太大了就把这些衣服整理成了 pdf, 要是学专业课也这么认真就好了
国采展.pdf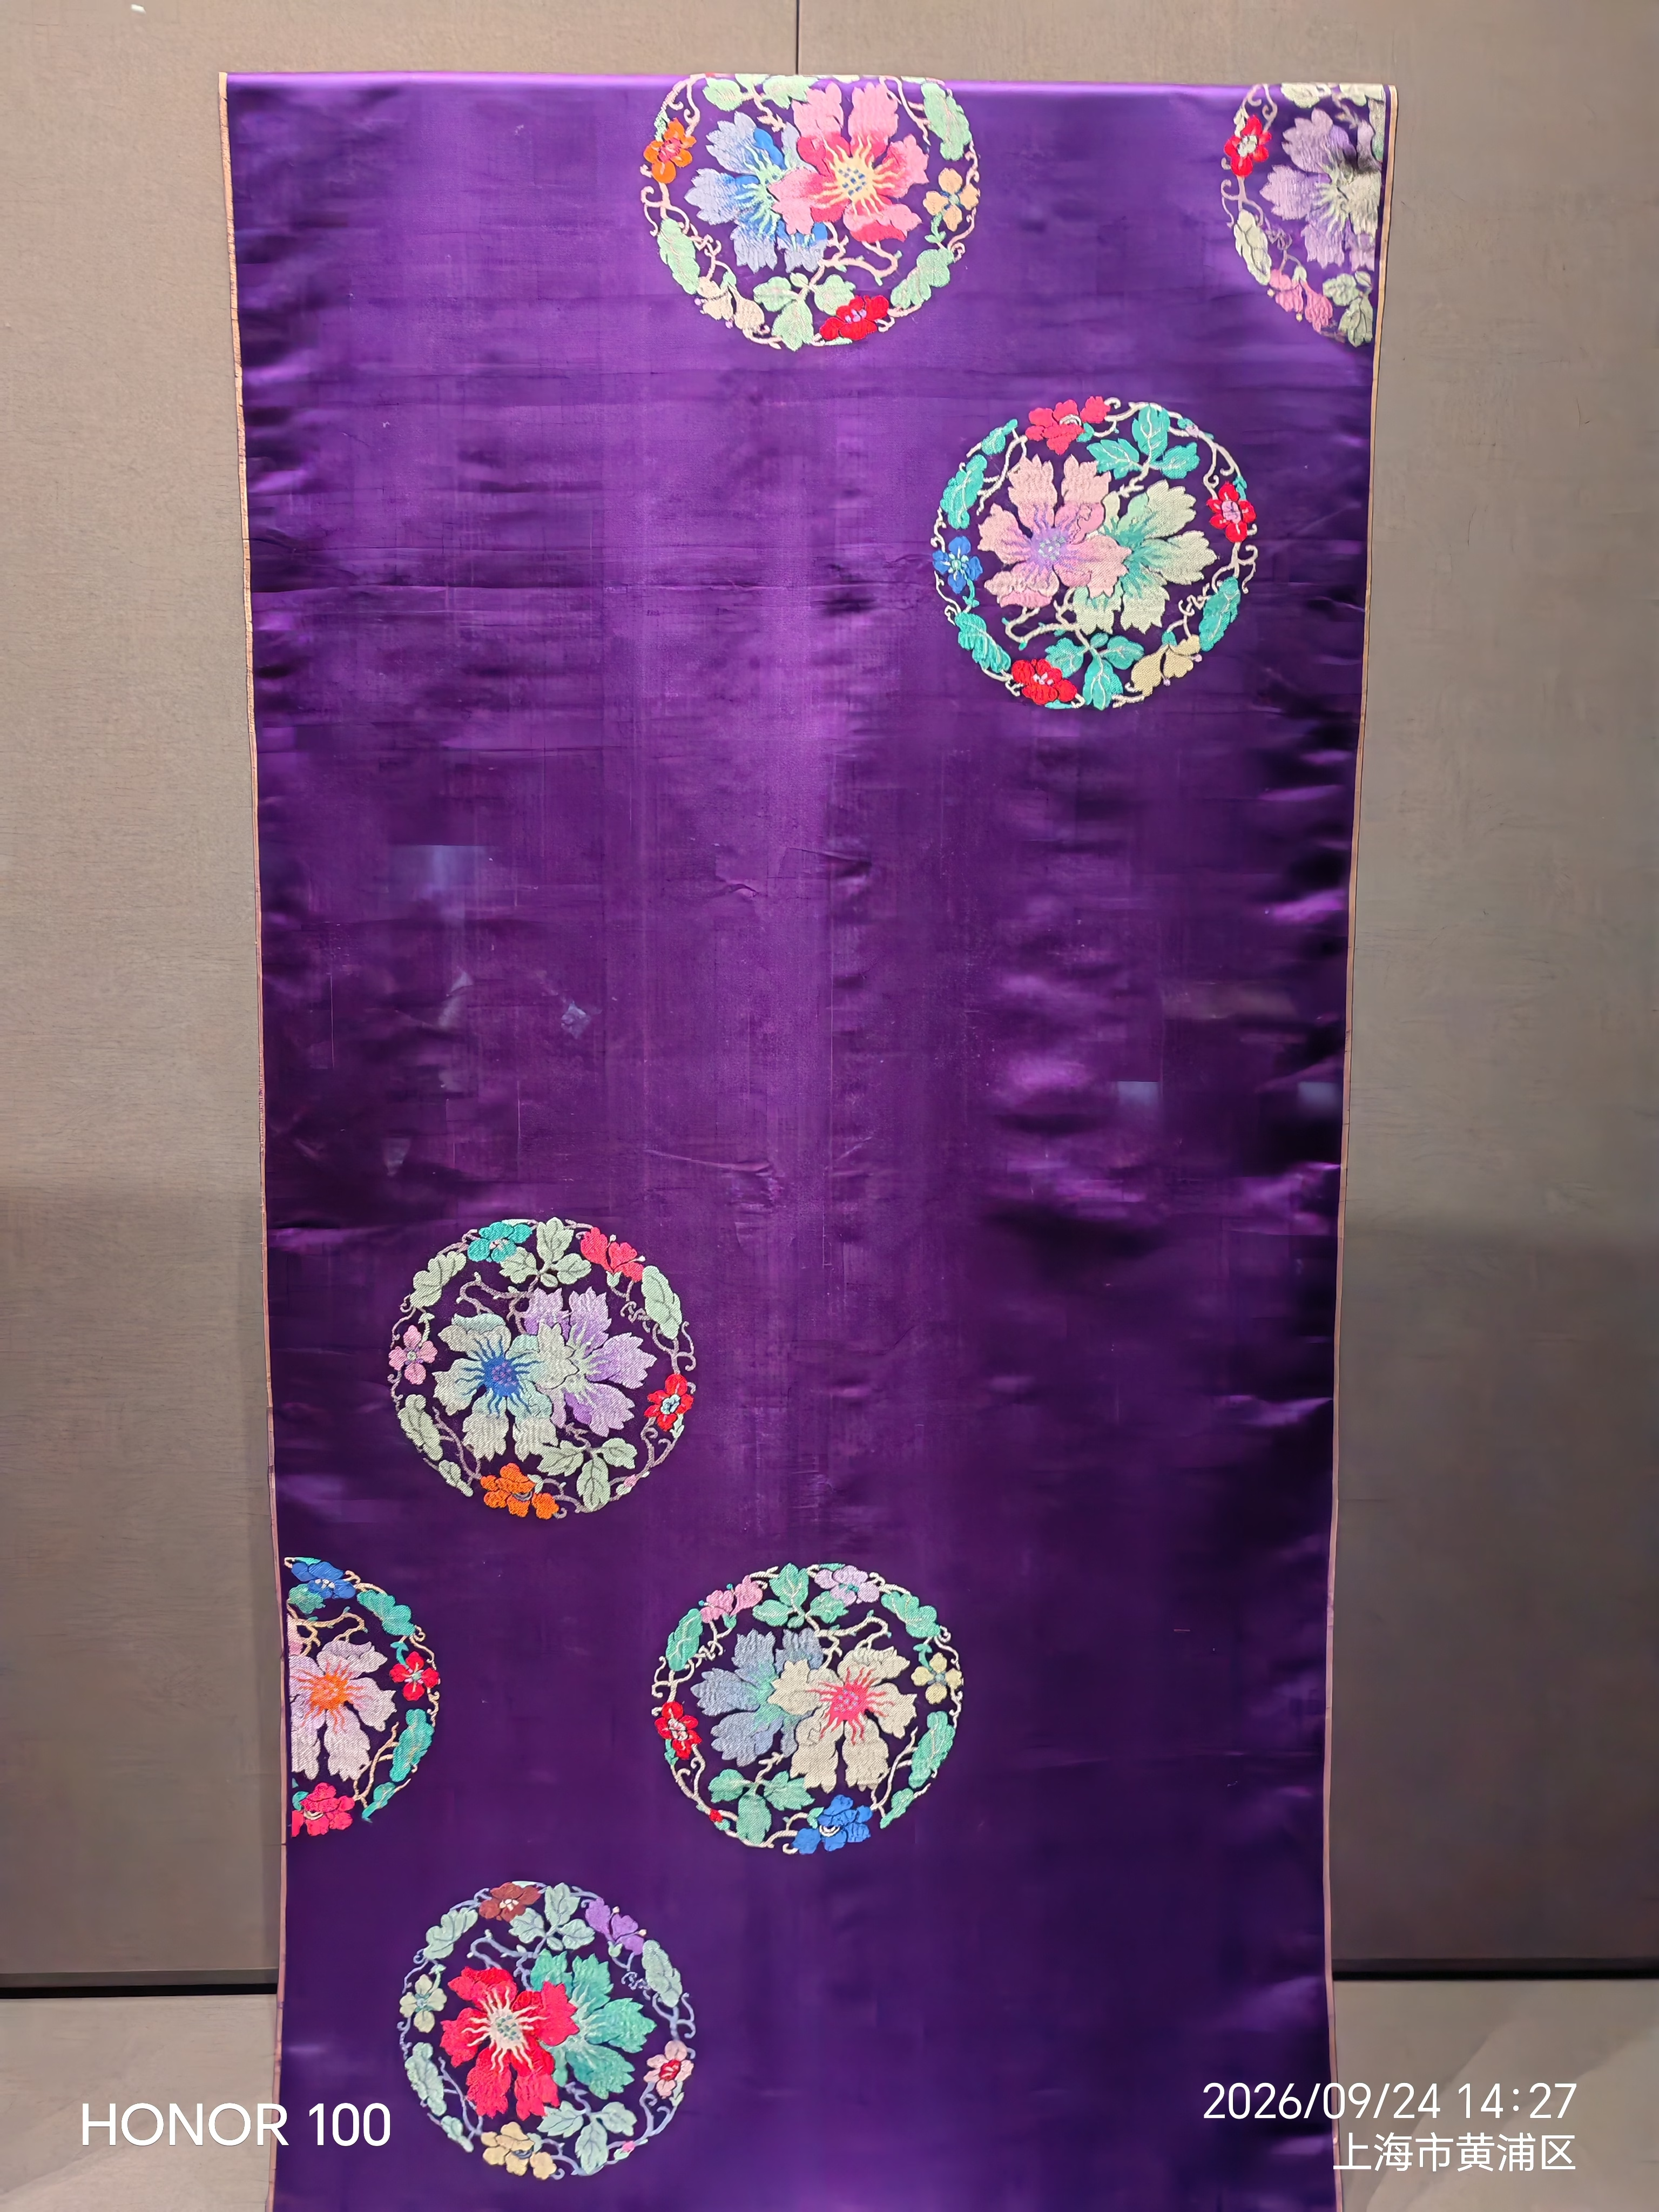
- ZZethes Post #284
前半:金融逻辑
第 1 步:为什么"无条件"必然产生道德风险
- 结构错配是根源:资金提供方承担绝大部分下行风险,原股东保留全部上行收益。于是借款人的最优策略变成"拿别人的钱赌自己的运气"——赢了归我,输了归你。
- 所以救助/融资设计的第一原则:借款人必须先证明"我自己也承担损失"(即 skin in the game / bail-in 逻辑)。
第 2 步:信号清单——每一条都是"损失吸收能力"
- 正的资本缓冲:自有资本先亏;
- 次级资本:自愿把自己的钱排在资提供方后面受偿;
- 未抵押资产:留出未被占用的资产作最后偿付;
- 股东注资:原股东掏真金白银,证明仍相信企业且愿意付代价;
- 限制分红和回购:防止救助钱到账前资产被向上转移;
- 更严格的信息披露与控制权条件:让渡信息权与决策权。
共同点:每一条都有成本,且成本恰好落在借款人自己身上,所以才是可信信号 (costly signaling)。
第 3 步:机制设计——合同选择本身就是信息 (画红线的句子)
- 真正有偿债能力的机构:最在乎持续经营价值,故愿意接受"严格但暂时"的约束——它知道自己熬得过约束期;
- 价值已严重不足的机构:更倾向于无条件、无抵押、低约束融资——因为它通不过任何查验,真实目的是把窟窿转移给资金方;
- 于是"是否愿意接受能暴露真实资产质量的合同条件"构成一个分离均衡 (self-selection):类型通过合同选择自动暴露。这就是"本身就是信息"的含义。
- 现实对应:IMF 救助的条件性、央行"好抵押品 + 惩罚利率"的最后贷款人原则、困境企业救助中"先注资重组、再谈救援"的惯例。共同智慧:拒绝查验者,不配无条件拿钱。
后半
- 诗篇 44:22("我们为你的缘故终日被杀;人看我们如将宰的羊"):群体哀歌,说守约之爱的代价是被宰杀;作者借此点出:提供无条件的爱,历史结局是被爱的对象所杀。
- 约翰 10:18("没有人夺我的命去,是我自己舍的"):好牧人讲论,强调预知与自愿——死亡不是信息失误或意外事故,而是自选的代价。
- ZZethes Post #280
这些总结是比较重要的行为习惯,最主要的是光线控制(接触睡起 1h 内的户外光线,接触傍晚户外光线,避免夜晚光线)
记录里面还有起床和入睡时间,尽量保持固定的时间区间(±30 分钟内),睡眠规律比睡眠不规律群体的全因死亡率低 50% 左右。
 Ryan Post #3
2026 复旦预推免机考题回忆
写在前面
总共五道题目,两个半小时。提供测试样例,考试过程中提交的代码是使用已经提供了的测试样例测试的,测试数据也会以压缩包形式发放(.in 和.out 文件,可以学一下 freopen 的使用),并非真实测试点数据。提供测试样例可能 2~4 个,真实测试点数据可能 10 个。
A 题 扫雷
题目描述
给定一个 的扫雷地图。地图中每个位置可能是地雷,也可能是空地。
输入中使用字符
'*'表示该位置存在地雷,使用字符'#'表示该位置不存在地雷。请根据给定地图输出处理后的扫雷地图。对于每一个位置:
- 如果该位置是地雷,则仍然输出
'*'; - 如果该位置不是地雷,则输出其周围八个相邻位置中地雷的数量。
这里的“周围八个相邻位置”指以当前位置为中心的 九宫格中除当前位置本身以外的其他位置。对于位于地图边界或角落的位置,只统计实际存在于地图中的相邻位置。
输入格式
第一行输入两个整数 ,分别表示地图的行数和列数。
接下来 行,每行包含 个字符,描述扫雷地图。其中:
'*'表示地雷,'#'表示非地雷位置。输出格式
输出 行,每行包含 个字符。
对于地雷位置输出
'*',对于非地雷位置输出其周围八个位置中的地雷数量。思路
直接模拟即可。
遍历整个 的地图。对于当前位置 ,如果该位置本身是地雷,那么直接输出
'*'。如果当前位置不是地雷,则枚举以当前位置为中心的九宫格,也就是行坐标从 到 ,列坐标从 到 。对于每一个候选位置,首先判断它是否仍然位于地图范围内,然后判断该位置是否为地雷。如果是地雷,则计数器加一。
由于当前位置本身确定不是地雷,所以即使将当前位置也包含在九宫格枚举中,也不会影响最终统计结果。当然,也可以显式跳过当前位置。
每个格子最多检查 9 个位置,因此总时间复杂度为 O(nm)
空间复杂度为 ,用于保存输入地图。
完整 C++ 代码
#include <bits/stdc++.h> using namespace std; int main() { ios::sync_with_stdio(false); cin.tie(nullptr); int n, m; cin >> n >> m; vector<string> grid(n); for (int i = 0; i < n; i++) { cin >> grid[i]; } for (int i = 0; i < n; i++) { for (int j = 0; j < m; j++) { if (grid[i][j] == '*') { cout << '*'; continue; } int cnt = 0; for (int x = i - 1; x <= i + 1; x++) { for (int y = j - 1; y <= j + 1; y++) { if (x < 0 || x >= n || y < 0 || y >= m) { continue; } if (grid[x][y] == '*') { cnt++; } } } cout << cnt; } cout << '\n'; } return 0; }这题本质上就是一个很标准的二维网格八方向邻域模拟题,机考里主要考察二维数组遍历和边界处理。
B 题 化学式
题目描述
给定一个表示“化学式”的字符串。字符串仅由大写字母、小写字母、数字以及左右括号
(、)组成。题目保证输入字符串的语法合法,但其中出现的元素名称不一定是真实存在的化学元素。一个元素名称一定以一个大写字母开头,后面可以跟若干个小写字母。例如
H、O、Mg、Abc都可以视为合法的元素名称。元素或括号整体后面可以跟一个正整数,表示该元素或括号内所有元素出现次数的倍数。如果后面没有数字,则默认倍数为 1。
括号可以嵌套。
请统计整个化学式中不同元素的种类数,以及每种元素最终出现的总次数。
输出时,元素按照字典序升序排列。
例如:
输入:
Mg(OH)2对应元素数量为:
H 2
Mg 1
O 2
输入:
K4(ON(SO3)2)2对应元素数量为:
K 4
N 2
O 14
S 4
输入格式
输入一行字符串 ,表示给定的化学式。
字符串由大写字母、小写字母、数字以及
(、)组成,并保证语法合法。输出格式
第一行输出一个整数,表示不同元素的种类数。
接下来每行输出一种元素及其出现次数,格式为:
元素名称 出现次数所有元素按照元素名称的字典序升序输出。
思路
这道题的核心是括号嵌套下的字符串解析。
可以使用栈来处理括号。栈中的每一层保存一个
map<string, long long>,表示当前这一层括号内已经统计出的元素数量。首先建立一个空的
map作为最外层。从左到右扫描字符串。
如果当前位置是大写字母,说明遇到了一个新的元素。先读取这个大写字母,再继续读取其后连续的小写字母,从而得到完整的元素名称。之后继续读取紧跟在元素名称后面的数字。如果不存在数字,则认为数量为 1。最后将这个元素及其数量加入当前最内层的
map中。如果遇到左括号
(,说明开始了一个新的括号层级,此时向栈中加入一个新的空map。如果遇到右括号
),说明当前括号结束。先取出当前最内层的map,然后继续读取右括号后面的数字作为整个括号的倍数。如果没有数字,则倍数为 1。随后将括号内每一种元素的数量乘以这个倍数,再累加到上一层的map中。因为括号可能嵌套,例如
K4(ON(SO3)2)2所以栈正好可以自然地处理这种层级关系。
以
(SO3)2为例,首先在新的一层中得到S 1 O 3遇到右括号后整体乘以 2,得到
S 2
O 6
然后累加到外层。最外面的括号最终又整体乘以 2,因此得到最终答案。
最后栈底的
map就是整个化学式的统计结果。由于map本身会按照字符串字典序排序,因此可以直接按照顺序输出。假设字符串长度为 ,每个字符只会被扫描常数次。考虑
map插入操作后,整体时间复杂度可以近似看作 O(nlog k) 其中 为不同元素的种类数。空间复杂度为 O(n) 最坏情况下括号嵌套深度和元素数量都可能与字符串长度同阶。
完整 C++ 代码
#include <bits/stdc++.h> using namespace std; int main() { ios::sync_with_stdio(false); cin.tie(nullptr); string s; cin >> s; vector<map<string, long long>> st; st.push_back({}); int n = s.size(); for (int i = 0; i < n; ) { if (isupper(s[i])) { string element; element += s[i++]; while (i < n && islower(s[i])) { element += s[i++]; } long long num = 0; while (i < n && isdigit(s[i])) { num = num * 10 + (s[i] - '0'); i++; } if (num == 0) { num = 1; } st.back()[element] += num; } else if (s[i] == '(') { st.push_back({}); i++; } else if (s[i] == ')') { i++; long long num = 0; while (i < n && isdigit(s[i])) { num = num * 10 + (s[i] - '0'); i++; } if (num == 0) { num = 1; } map<string, long long> cur = st.back(); st.pop_back(); for (auto &[element, cnt] : cur) { st.back()[element] += cnt * num; } } } cout << st[0].size() << '\n'; for (auto &[element, cnt] : st[0]) { cout << element << ' ' << cnt << '\n'; } return 0; }这题本质上是一个比较典型的字符串解析 + 栈处理嵌套结构问题。相比 A 题,主要考察的是如何识别变长的元素名称、变长数字,以及如何处理括号的递归倍数关系。
C 题 Belady 换页
题目描述
有一个容量为 的缓存区,共包含 个缓存块,编号为 。
现在依次进行 次查询,第 次查询访问键值
key[i]。对于每一次查询,需要判断当前查询的键值是否已经存在于缓存区中,并按照指定的 Belady 最优换页策略决定是否进行缓存替换。
如果
key[i]已经存在于缓存区的第 个缓存块中,则本次查询命中,输出:hit x其中 。
如果
key[i]当前不在缓存区中,则本次查询未命中,输出:miss y其中 。
y的含义如下:y = 0:本次查询的key[i]最终没有进入缓存;1 <= y <= m:本次查询的key[i]被放入或替换到了编号为 的缓存块中。
如果发生未命中,并且当前缓存区中存在空闲缓存块,则直接将
key[i]放入一个空闲缓存块中。如果缓存区已经被占满,则需要按照 Belady 最优换页策略决定淘汰对象。
与普通 Belady 算法不同的是,当前查询的
key[i]本身也参与淘汰候选。也就是说,此时一共有 个候选:当前查询的 key[i] 缓存块 1 中的 key 缓存块 2 中的 key ... 缓存块 m 中的 key对于每一个候选,考察它在后续查询序列 key[i+1],key[i+2], ... ,key[n] 中下一次出现的位置。如果之后再也不会出现,则认为它的下一次访问时间为无穷远。
淘汰下一次访问时间最远的候选。
当存在多个候选拥有相同的最远访问时间时,淘汰候选编号最小的一个。这里可以将当前查询的
key[i]看作编号0,原有的 个缓存块编号仍为 。因此,如果当前查询的
key[i]本身被淘汰,则缓存区保持不变,并输出:miss 0特别地,如果当前查询的 key 和缓存中的所有 key 在之后都不会再次被访问,那么它们的下一次访问时间均为无穷远。由于当前查询可以视为编号
0的候选,因此淘汰当前查询的 key,输出miss 0。输入格式
第一行输入两个整数 ,其中:
- 表示查询次数;
- 表示缓存块数量。
接下来 行,每行输入一个键值
key[i],表示第 次查询访问的 key。输出格式
对于每一次查询输出一行。
如果查询命中缓存块 ,输出:
hit x如果查询未命中,输出:
miss y其中:
y = 0表示该 key 没有进入缓存;y = 1...m表示该 key 被放入对应编号的缓存块。
思路
这道题本质上是在模拟 Belady 最优换页算法,但是与经典版本相比多了一个非常关键的变化:发生缺页时,新访问的 key 也可以直接被淘汰,从而不进入缓存。
对于第 次查询,首先检查
key[i]是否已经存在于缓存中。如果存在,直接输出对应缓存块编号,不需要修改缓存。如果没有命中,再检查缓存中是否还有空闲块。如果存在空闲块,那么不需要执行换页算法,直接将当前 key 放入空闲缓存块即可。
真正需要处理的是“缓存已满且本次 miss”的情况。
此时将当前查询
key[i]和缓存中的 个 key 一起作为候选。对于每一个候选,我们都需要知道它在第 次查询之后下一次什么时候会被访问。假设某一个候选下一次出现的位置越靠后,那么现在保留它的价值就越低。Belady 算法的原则就是:
淘汰未来最晚才会再次使用的元素。
如果一个元素以后再也不会访问,可以把它的下一次访问位置看成正无穷,因此它优先被淘汰。
一个最直接的方法是,每次发生需要替换的 miss 时,都从
i + 1开始向后扫描,寻找所有候选第一次出现的位置。但最坏情况下会产生 甚至接近 的复杂度。更好的做法是从后向前预处理每一次查询之后,同一个 key 下一次出现的位置。
例如定义:
nextPos[i]表示
key[i]在位置 之后下一次出现的位置。如果以后不会再出现,则令它为一个很大的数INF。从后向前遍历查询序列,并利用哈希表记录每一个 key 最近出现的位置,就可以在 期望时间内得到所有
nextPos[i]。但是,对于缓存中的 key,我们还需要动态知道它们从当前位置开始下一次什么时候出现。因此可以进一步为每一种 key 保存它所有出现位置的数组,然后在处理第 次查询时,通过
upper_bound查找第一个大于 的位置。对于每个候选 key:
upper_bound(pos[key].begin(), pos[key].end(), i)即可得到它在当前查询之后第一次出现的位置。
如果不存在,就认为下一次访问位置为
INF。接下来比较 个候选的下一次访问时间。编号规定为:
0 -> 当前查询 key[i] 1...m -> 对应缓存块选择下一次访问位置最大的候选。如果存在多个并列,由于要求淘汰编号最小的候选,因此只在遇到严格更大的下一次访问位置时更新答案即可。从编号
0开始枚举,就可以自然实现这个规则。如果最终选择的编号为
0,说明当前查询的 key 自己就是最应该被淘汰的元素,因此缓存不发生变化,输出:miss 0否则假设选择缓存块
y,则用当前查询的 key 替换该位置,并输出:miss y如果每次需要替换时检查 个候选,每个候选通过二分查找下一次位置,那么时间复杂度为 O(nmlog n) 如果题目中的 较小,这种写法已经足够直接和稳定。
如果 都很大,还可以通过维护每个缓存 key 的下一次访问时间,并结合优先队列进一步优化。不过从这道题“模拟换页策略”的出题方式来看,直接维护缓存并查询未来位置通常是最容易实现且最不容易写错的方案。
完整 C++ 代码
#include <bits/stdc++.h>
using namespace std;

int main() {
    ios::sync_with_stdio(false);
    cin.tie(nullptr);

    int n, m;
    cin >> n >> m;

    vector<int> key(n + 1);

    // pos[x] 保存 key=x 出现的所有位置
    unordered_map<int, vector<int>> pos;

    for (int i = 1; i <= n; i++) {
        cin >> key[i];
        pos[key[i]].push_back(i);
    }

    // cache[1...m]
    // 用 optional 的效果,这里用 occupied 判断是否为空
    vector<int> cache(m + 1);
    vector<bool> occupied(m + 1, false);

    const int INF = n + 1;

    // 查询 x 在位置 cur 之后下一次出现的位置
    auto getNext = [&](int x, int cur) {
        auto &v = pos[x];

        auto it = upper_bound(v.begin(), v.end(), cur);

        if (it == v.end()) {
            return INF;
        }

        return *it;
    };

    for (int i = 1; i <= n; i++) {
        int x = key[i];

        // 1. 判断是否命中
        int hitPos = -1;

        for (int j = 1; j <= m; j++) {
            if (occupied[j] && cache[j] == x) {
                hitPos = j;
                break;
            }
        }

        if (hitPos != -1) {
            cout << "hit " << hitPos << '\n';
            continue;
        }

        // 2. miss,先检查是否存在空闲缓存块
        int emptyPos = -1;

        for (int j = 1; j <= m; j++) {
            if (!occupied[j]) {
                emptyPos = j;
                break;
            }
        }

        if (emptyPos != -1) {
            cache[emptyPos] = x;
            occupied[emptyPos] = true;

            cout << "miss " << emptyPos << '\n';
            continue;
        }

        // 3. 缓存已满
        // 当前查询 x 也参与候选,编号视为 0

        int replace = 0;
        int farthest = getNext(x, i);

        // 比较缓存块 1...m
        //
        // 只有 next 严格更大时才更新。
        // 若相同,则保留编号更小的候选。
        for (int j = 1; j <= m; j++) {
            int nxt = getNext(cache[j], i);

            if (nxt > farthest) {
                farthest = nxt;
                replace = j;
            }
        }

        // 4. 根据淘汰对象决定是否进入缓存
        if (replace == 0) {
            // 当前查询自己被淘汰
            cout << "miss 0\n";
        } else {
            // 替换对应缓存块
            cache[replace] = x;
            cout << "miss " << replace << '\n';
        }
    }

    return 0;
}
这道题最值得注意的地方并不是普通的 Belady 算法,而是题目允许**“新来的 key 自己被淘汰”**。因此每次缓存已满发生 miss 时,实际上是在 个元素之间选择未来最晚访问的一个,而不是只在已有的 个缓存块之间选择。
另外,根据你现在回忆出的题意,我认为最自然的编号规则就是把新来的
key[i]看成候选0,缓存块看成候选1...m,这样“最远访问时间相同时选择编号最小”和“所有元素以后都不访问时淘汰新 key,输出miss 0”两条规则正好能够统一起来。D 题 特殊的最长公共子序列
题目描述
给定两个长度均为 的整数序列 和 。
题目保证两个序列都是 的排列,即每个序列中都恰好包含一次整数 。
请计算两个序列的最长公共子序列(Longest Common Subsequence,LCS)的长度。
由于 n < 10^5 因此不能直接使用普通最长公共子序列的 动态规划算法。
输入格式
第一行输入一个整数 ,表示两个排列的长度。
第二行输入 个整数,表示排列 。
第三行输入 个整数,表示排列 。
两个序列均为 的排列。
输出格式
输出一个整数,表示 和 的最长公共子序列长度。
思路
普通最长公共子序列问题通常使用二维动态规划,时间复杂度为 。但本题 可以达到 ,显然无法接受。
本题最关键的特殊条件是:两个序列都是 的排列,每个数字只出现一次。
因此可以利用数字在两个排列中的相对位置,将 LCS 问题转化为 LIS,也就是最长上升子序列问题。
首先记录第一个排列中每个数字出现的位置。设 pos 表示数字 在 中的位置。
例如:
p1 = 3 1 5 2 4那么有:
pos[3] = 1
pos[1] = 2
pos[5] = 3
pos[2] = 4
pos[4] = 5
接下来按照第二个排列 的顺序,将其中的每一个数字替换成它在 中的位置。
例如:
p1 = 3 1 5 2 4
p2 = 1 2 3 4 5
根据 中的位置,可以将 转换为:
2 4 1 5 3现在考虑两个排列的公共子序列。
如果若干个数字能够按照相同顺序同时出现在 和 中,那么这些数字在 中从左到右出现时,它们在 中的位置也一定是严格递增的。
反过来,如果转换后的序列中存在一个严格递增子序列,那么对应的这些数字在 和 中的相对顺序完全相同,因此一定构成两个排列的公共子序列。
所以:
两个排列的 LCS = 位置映射后序列的 LIS
于是问题转化成求一个长度为 的序列的最长严格上升子序列。
由于 ,使用经典的“贪心 + 二分”方法求 LIS。
维护数组
d,其中d[len - 1]表示长度为len的上升子序列中,结尾元素能够取得的最小值。从左向右处理转换后的每个位置
x:如果
x大于d中的最后一个元素,说明可以直接接在当前最长上升子序列后面,将x加入d。否则使用
lower_bound找到d中第一个大于等于x的位置,并将其替换成x。这样不会改变当前 LIS 的长度,但可以让同样长度的上升子序列末尾尽可能小,为之后接入更多元素创造条件。最终
d.size()就是最长上升子序列长度,也就是原问题的最长公共子序列长度。建立位置映射需要 ,求 LIS 需要 ,因此总时间复杂度为 O(nlog n)
空间复杂度为 O(n)
完整 C++ 代码
#include <bits/stdc++.h>
using namespace std;

int main() {
    ios::sync_with_stdio(false);
    cin.tie(nullptr);

    int n;
    cin >> n;

    vector<int> pos(n + 1);

    for (int i = 1; i <= n; i++) {
        int x;
        cin >> x;
        pos[x] = i;
    }

    vector<int> d;

    for (int i = 1; i <= n; i++) {
        int x;
        cin >> x;

        // 将 p2 中的元素转换成它在 p1 中的位置
        int p = pos[x];

        auto it = lower_bound(d.begin(), d.end(), p);

        if (it == d.end()) {
            d.push_back(p);
        } else {
            *it = p;
        }
    }

    cout << d.size() << '\n';

    return 0;
}
这道题最核心的考点就是发现**“两个排列的 LCS 可以通过位置映射转化成 LIS”**。题目特意给出“两个序列都是 的排列”以及 ,基本就是在提示不能做普通二维 LCS,而要利用排列的唯一性完成这个转化。
E 题 充电路径
题目描述
给定一个包含 个城市和 条有向道路的图。
第一行输入四个整数:
n m s C其中:
- 表示城市数量;
- 表示道路数量;
- 表示初始电量;
- 表示电池最大容量。
接下来输入 行,每行三个整数:
u v w表示存在一条从城市 到城市 的单向道路,通过这条道路需要消耗 单位电量。
接下来输入 行,每行两个整数:
id p表示编号为 的城市中,每充 单位电量需要花费 。
如果 ,表示该城市没有充电桩,因此不能在该城市充电。
汽车从城市 出发,初始拥有 单位电量,电池容量上限为 。任意时刻电量都不能超过 。
在存在充电桩的城市中,可以根据需要选择充任意整数单位的电量,每充 单位需要支付该城市对应的价格 。
经过一条耗电量为 的道路时,当前电量必须至少为 ,经过道路后电量减少 。
要求计算从城市 到城市 所需要支付的最小充电费用。
如果无法到达城市 ,输出:
-1输入格式
第一行输入四个整数:
接下来 行,每行输入三个整数:
表示一条从 到 的单向道路,经过该道路消耗 单位电量。
接下来 行,每行输入两个整数:
表示城市 的充电价格为 。若 ,则该城市没有充电桩。
输出格式
输出一个整数,表示从城市 到城市 的最小充电费用。
如果无法到达城市 ,输出:
-1说明 / 数据范围
前 的数据满足所有道路的电量消耗均为 。
时间限制: 秒。
空间限制: MB。
思路
这道题不能只把“当前所在城市”作为最短路状态,因为到达同一个城市时,剩余电量不同,会直接影响之后能否通过某条道路以及还需要花多少钱充电。
因此需要同时记录:
由于电池容量满足
电量状态非常少,因此可以把原图扩展成一个状态图。
定义:
表示到达城市 ,并且当前剩余 单位电量时,已经支付的最小充电费用。
其中:
初始位于城市 ,初始电量为 ,因此:
对于一个状态 ,有两种可能的操作。
第一种操作是充电。
如果城市 存在充电桩,即
并且当前电量还没有达到容量上限:
那么可以充 单位电量:
这次操作需要支付:
因此可以进行松弛:
之所以只考虑“一次充一格”,是因为连续充多格电可以通过多次这样的状态转移实现。例如充 格就是:
第二种操作是经过道路。
假设存在一条道路:
耗电量为 。
如果当前电量满足:
那么可以通过这条道路,到达城市 后剩余电量为:
通过道路本身不需要支付额外费用,因此:
由于所有充电费用 都是非负数,道路转移费用为 ,因此整个状态图中的边权都是非负的,可以使用 Dijkstra 算法求最短路。
最终到达城市 时,剩余多少电量都可以,因此答案为:
如果所有状态都不可达,则输出
-1。
这里还有一个非常重要的优化。
题目给出:
而道路耗电量 最大可以达到 。
如果:
那么无论如何充电,电池最多也只有 单位电量,因此这条道路永远不可能经过,可以在建图时直接忽略。
这样可以减少一些无效边。
状态总数为:
由于 ,最多约为:
个状态。
每个状态最多进行一次充电转移,并枚举当前城市的所有出边,因此总转移规模约为:
使用 Dijkstra 后,时间复杂度约为:
空间复杂度约为:
由于 很小,这正是本题能够处理 的关键。
完整 C++ 代码
#include <bits/stdc++.h>
using namespace std;

using ll = long long;

struct Edge {
    int to;
    int w;
};

struct State {
    ll cost;
    int u;
    int energy;

    bool operator>(const State& other) const {
        return cost > other.cost;
    }
};

int main() {
    ios::sync_with_stdio(false);
    cin.tie(nullptr);

    int n, m, s, C;
    cin >> n >> m >> s >> C;

    vector<vector<Edge>> graph(n + 1);

    for (int i = 0; i < m; i++) {
        int u, v;
        long long w;
        cin >> u >> v >> w;

        // 电池最大容量只有 C,w > C 的边永远无法经过
        if (w <= C) {
            graph[u].push_back({v, (int)w});
        }
    }

    vector<ll> price(n + 1);

    for (int i = 0; i < n; i++) {
        int id;
        ll p;

        cin >> id >> p;
        price[id] = p;
    }

    const ll INF = (1LL << 62);

    vector<vector<ll>> dist(
        n + 1,
        vector<ll>(C + 1, INF)
    );

    priority_queue<
        State,
        vector<State>,
        greater<State>
    > pq;

    dist[1][s] = 0;
    pq.push({0, 1, s});

    while (!pq.empty()) {
        auto [cost, u, energy] = pq.top();
        pq.pop();

        if (cost != dist[u][energy]) {
            continue;
        }

        // 如果已经到达终点,
        // Dijkstra 第一次弹出终点状态时就是全局最优答案
        if (u == n) {
            cout << cost << '\n';
            return 0;
        }

        // 操作 1:充 1 格电
        if (price[u] > 0 && energy < C) {
            ll newCost = cost + price[u];

            if (newCost < dist[u][energy + 1]) {
                dist[u][energy + 1] = newCost;

                pq.push({
                    newCost,
                    u,
                    energy + 1
                });
            }
        }

        // 操作 2:经过道路
        for (auto [v, w] : graph[u]) {
            if (energy < w) {
                continue;
            }

            int newEnergy = energy - w;

            if (cost < dist[v][newEnergy]) {
                dist[v][newEnergy] = cost;

                pq.push({
                    cost,
                    v,
                    newEnergy
                });
            }
        }
    }

    cout << -1 << '\n';

    return 0;
}
这题真正的突破点就是看到:
这个非常小的数据范围。
它实际上是在强烈提示:把电量离散成状态维度。
于是原本看起来像“路径规划 + 动态充电决策”的复杂问题,就变成了:
上的最短路。
- 如果该位置是地雷,则仍然输出
-
 羽流弦ノ迹 Post #5
Admin 是打算把这套论坛系统用到其他网站或者做成开源软件吗?如果只有門用的话不知道单独起名字的意义诶。
不过单独给这套论坛架构起名的话,可以稍微超脱一点俗套,比如
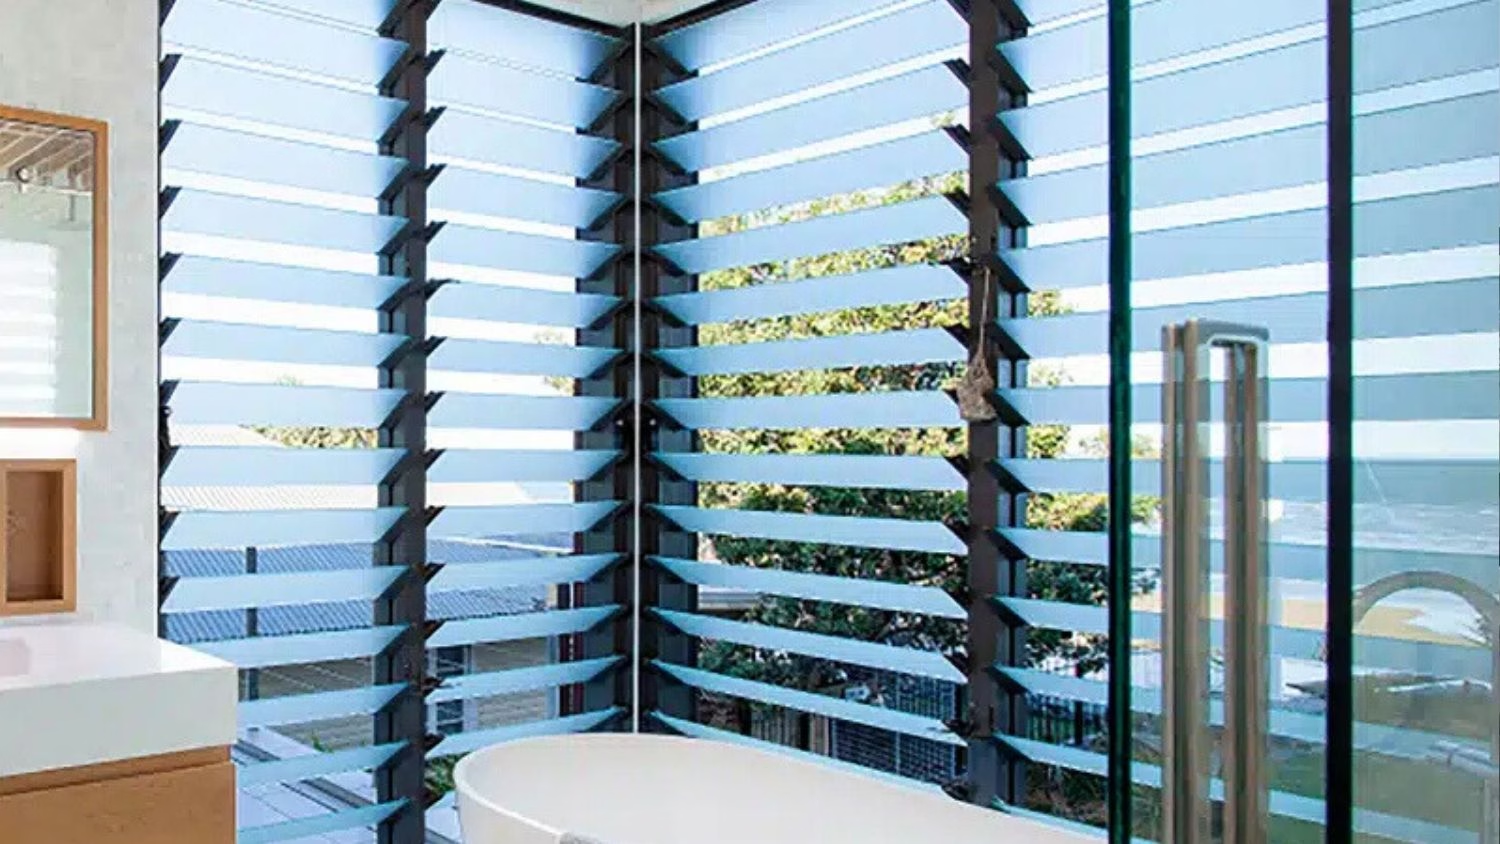
Jalousie 百叶窗?(一般是玻璃的,虽然本站并没有使用毛玻璃材质。不过百叶窗象征很多条水平帖子的纵向排列,让人看到窗内外的见闻)下面摘自 Wikipedia:
Jalousie is the French word for "jealousy". It originated in 18th century France from the Italian word geloso, which means "jealous" or "screen", as in to screen something from view.
Because of their slatted louvres, jalousie windows protect the interior of the house from jealous, peering eyes (when not made of a transparent material like glass).
 PipaQinse233 Post #466
梦见白天的群聊记录,笑醒了;但是醒来一想自己还没收到这通知,更难绷了🤣
- Aanonymous Post #3
举个例子,在农业文明时代,财富就是土地和人口。那么,今天土地还是不是财
富?回顾整个世界历史,尤其是在欧洲,封建体系持续了数百上千年,很多国家的封建制
度都因革命而瓦解了,除了一个例外——英国。这几百年来,英国没有发生大的革命,许
多原本拥有土地的贵族至今还保留着很多土地和宏伟的城堡。在过去,他们是最富有的人。
然而,今天这些贵族还富有吗?答案是否定的。大多数仅拥有土地和城堡的贵族已经不再
富有,甚至变得相对贫穷。只有少数贵族依然富裕,是因为他们有其他投资,而不是仅仅
依赖原有的土地和城堡。
为什么会这样?因为维持土地和城堡需要大量人力。一个大型城堡动辄需要几十甚
至上百的佣人来维持运转。然而,过去几百年间,人的价值发生了巨大的变化,导致今天
的贵族已无法负担如此多的佣人。同样地,土地也需要雇人耕作,人的价值增加了,土地
本身的产出增加相对比较少,乡间房子价值的增加也很少,维修成本反而很高。所以,这
些没有转化成工业商业用途的土地城堡成了贵族们的负担,而没有成为财产。今天,仍能
维持土地和城堡的英国贵族,大多是通过将城堡开放给公众参观来获取收入。例如,将城
堡当作公园开放,收取每人五英镑的门票费用。我相信在座有很多人到英国旅游,参观过
类似的城堡,甚至还有人租用城堡举办生日宴会、公司晚会、婚礼等等。这是一个土地和
人口的相对价值变化的例子。 - Aanonymous Post #4
我们来回顾一下价值投资的起源。价值投资正
是诞生于整个经济和宏观环境极度动荡、充满困惑的时期。最早完整阐述价值投资理念的
人是本·格雷厄姆(Ben Graham),也就是巴菲特的老师。那么格雷厄姆是什么时候开始
理解和实践价值投资的?他最早从 1926 年开始投资,前三年中,他与很多投资者一样,
经历了“咆哮的二十年代”(Roaring Twenties),期间也做了很多投机操作。然而,
1929 至 1932 年的大萧条时期,他的投资合伙企业的帐面价值损失高达 70%。痛定思痛,
他才开始真正实践价值投资,并于 1932-1935 年成功弥补了之前的亏损。1936 年,他创
立了一个新的封闭式基金(closed fund),运营至 1956 年结束,二十年间实现了非凡的
回报。期间,他于 1949 年出版了《聪明的投资者》,首次完整地阐述了价值投资的最重
要的三个理念价值投资的奠基人格雷厄姆,正是在宏观经济面临巨大挑战时发现了价值投资的方
法论。他在那个时代所经历的比我们今天面对的挑战要困难得多。当时,美国的失业率高
达 25%,整个经济体萎缩了约三分之一到一半,具体比例取决于不同的评估方法。人们普
遍感到前途渺茫,世界仿佛快走向末日。等他终于回本,开始新的基金时,世界又迅速陷
入一场法西斯发动的全球性战争,这场战争最终导致上亿人死亡,数亿人受伤,世界上大
部分的工业体系被彻底摧毁。在这样的时代背景下,他创造了卓越的投资业绩。另一位对价值投资的理论和实践做出巨大贡献的是经济学家凯恩斯。很多人都熟悉
凯恩斯的宏观经济理论,以及他对战后布雷顿森林体系和全球金融体系设计的贡献,但是
很少有人知道凯恩斯也是一位优秀的价值投资人。从 1921 年到他 1946 年离世,凯恩斯管
理着剑桥大学最重要的国王学院的捐赠基金,25 年间积累了卓越的投资业绩。凯恩斯早
期也曾有过很多投机,但是在不断的经验教训中,他开始总结出价值投资的核心理念。凯
恩斯与格雷厄姆的事业轨迹高度重合,都经历了“咆哮的二十年代”、大萧条和世界大
战。不过,与格雷厄姆不同的是,凯恩斯所在的英国在二战期间处于战火前线,而格雷厄
姆所在的美国则处于战争的大后方,因此凯恩斯在这样的背景下创造出的业绩更具意义。还有一位约翰·邓普顿(John Templeton),他对价值投资以及把价值投资推广到
其他国家起到了重要作用。1939 年,正值战争期间,许多美国股票跌破一美元,邓普顿
秉持“便宜就是硬道理”的原则,将当时在美国股市中所有低于一美元的股票各买 100 股,
共投入一万美元。四年后,当他卖出时,104 只股票中有 100 只都取得了大幅上涨。1954
年,他创建了邓普顿基金(Templeton Fund),开始将价值投资理念推广到很多其他国家。
1992,这只基金经过 38 年的发展,历经市场的各种变化,取得了十几倍的收益我(李录)在 1997 年创建了喜马拉雅基金。在此之前,我在 1993 年买了第一只股票,就是
从买便宜的公司开始。在投资便宜公司的过程中,逐步建立起自己的能力圈,并从寻找便
宜的公司慢慢过渡到寻找优质且便宜的公司。1997 年,基金成立之初,我就经历了亚洲
金融危机。过去这几年中国市场经历了资本与资产的大幅回撤,许多人都遭遇了房地产、
股票和其他证券价格的下跌。然而这轮下跌的程度与当年的亚洲金融危机相比,依然不可
同日而语。1997-1998 年亚洲金融危机期间,亚洲主要国家的市场普遍下跌 70% 以上,最
惨烈的甚至跌了 90% 以上。我们的基金也同样面临了巨大的挑战,出现了比较大的波动,
但那几年的业绩总和恰恰是我们收益很高的一段时期,那时的市场可谓遍地黄金。 - Aanonymous Post #5
本·格雷厄姆
- 股票的本质是公司所有权:股票不是短期交易的筹码,而是公司所有权的法定证明。投资的根本目的,是在经济持续增长的过程中保持和增长自身的“购买力”。
- 正确利用“市场先生”:市场是由追求短期获利的人组成的,情绪化且神经质。它提供的价格往往大幅偏离真实价值。对价值投资者而言,市场提供的是“买卖的服务”,而不是“价值的指导”。
- 坚守“安全边际”:因为未来不可预测,投资者必须以足够低的价格买入。充足的安全边际不仅能抵御风险,还能让投资者在漫长的熊市中保持安心,坚持长期持有。
巴菲特与芒格
- 投资优质公司并坚守“能力圈”:长期的超额回报来自于优秀公司持续创造的内在价值。投资者必须明确自己的“能力圈”边界,只投资自己能真正理解的、资本回报率高于平均水平的优质公司,并长期持有。
芒格
- “在有鱼的地方钓鱼”(强调选择与独特优势):投资者不需要搞懂所有宏观经济或研究所有公司,关键是找到那个“有鱼的湖”——即竞争不充分、存在错误定价且自己深度了解的领域。通过建立独特的认知优势(如钓鱼向导 Lerer 的独家知识),避开过度竞争,获取丰厚回报。
李录
- 财富的本质与时代红利:基于对文明范式变化的总结,财富的本质是“经济体中的购买力占比”。因此,价值投资的终极目标是:在最具活力的经济体中,持有最具活力的公司的股份,从而顺应时代趋势,实现财富的长期保持与增长。
- Aanonymous Post #4
之前拿 AI 水过一篇类似的笔记
核心思想
通过构建一个无风险对冲投资组合来消除标的资产价格的随机性,再利用无套利原理推导出衍生品(如期权)的定价偏微分方程。
符号定义
符号 含义 $ S $ 标的资产(如股票)价格,是随机过程 $ V(S, t) $ 衍生品(如期权)价格,是 $ S $ 和时间 $ t $ 的函数 $ \Pi $ 构建的投资组合价值 $ \mu $ 资产的预期年化收益率(漂移项) $ \sigma $ 资产的年化波动率(风险度量) $ r $ 无风险利率(常数)
几何布朗运动(GBM)
假设资产价格短期内服从几何布朗运动:
- 漂移项:$ \mu S , dt $ 表示确定性增长趋势;
- 扩散项:$ \sigma S , dz $ 表示由随机冲击引起的波动。
- 标准维纳过程的微分增量 $ dz $:满足 $ dz \sim \mathcal{N}(0, dt) $
构建无风险对冲组合
投资组合构造
构建一个由1 份衍生品多头和**$ \Delta $ 份标的资产空头**组成的投资组合:
其中,选择对冲比率:
这一选择使得对冲组合对标的资产价格的一阶变动无关。
组合价值的瞬时变化
在无穷小时间 $ dt $ 内,组合价值变化为:
伊藤引理(Itô’s Lemma)
由于 $ V = V(S, t) $,且 $ S $ 是随机过程,需使用伊藤引理展开 $ dV $:
计算 $ (dS)^2 $
代入 $ dS = \mu S dt + \sigma S dz $,得:
根据伊藤微积分规则(当 $ dt \to 0 $):
- $ (dt)^2 \to 0 $
- $ dt \cdot dz \to 0 $
- $ (dz)^2 = dt $
因此:
代入伊藤引理
整理得:
代入对冲组合并消除随机性
将 $ dV $ 和 $ dS $ 代入 $ d\Pi = dV - \frac{\partial V}{\partial S} dS $:
展开后:
-
随机项(含 $ dz $):
-
确定性项(含 $ dt $):
因此,对冲后的组合无随机性:
无套利原理与 Black-Scholes PDE
由于 $ \Pi $ 是无风险组合,其收益率必须等于无风险利率 $ r $,否则存在套利机会。
无风险资产的增长满足:
将两种表达式联立:
两边除以 $ dt $,整理得 Black-Scholes 偏微分方程(PDE):
希腊字母
- **Delta ($ \Delta \frac{\partial V}{\partial S} $,对冲比率;
- **Gamma ($ \Gamma \frac{\partial^2 V}{\partial S^2} $,Delta 对价格的敏感度;
- **Theta ($ \Theta \frac{\partial V}{\partial t} $,时间衰减。
PDE 求解
变量分类
在实际应用中,我们将 Black-Scholes PDE 中的变量分为三类:
可观测的输入
这些是市场数据或合约条款,可以直接获取:
符号 含义 说明 $ S $ 标的资产现价 股票等标的资产的当前市场价格 $ K $ 行权价(Strike Price) 期权合约约定的执行价格 $ T $ 到期日(Expiry Date) 通常使用剩余到期时间 $ \tau = T - t $ $ r $ 无风险利率(Risk-Free Rate) 与期权期限匹配的国债收益率 $ q $ 股息率(Dividend Yield) 若标的资产支付股息,则需引入 不可直接观测的输入
符号 含义 $ \sigma $ 波动率(Volatility) - 估计方法:
- 历史波动率:基于过去价格收益率的标准差,反映历史波动,未必代表未来。
- 隐含波动率(Implied Volatility, IV):市场标准做法。将市场实际交易的期权价格 $ V_{\text{market}} $ 与其他已知参数代入 Black-Scholes 公式,反向求解出使模型价格等于市场价格的 $ \sigma $。
即:求解 $ V_{\text{BS}}(S, K, T, r, \sigma) = V_{\text{market}} $ 中的 $ \sigma $
最终要求解的 V
符号 含义 目标 $ V(S, t) $ 衍生品价格(Derivative Price) 理论公允价值,即模型输出 求解目标:
找到一个具体的定价函数 $ V(S, t) $,使其满足该 PDE 以及特定衍生品的边界条件与终值条件。
该函数 $ V(S, t) $ 的作用是:
给定任意时刻 $ t \lt T $ 和任意标的资产价格 $ S $,输出该衍生品的理论公允价值。
解析解
- 适用对象:欧式期权等结构简单、边界条件明确的衍生品。
- 方法:通过变量代换(如 $ x = \ln S $, $ \tau = T - t $)将 PDE 转化为热传导方程求解。
- 优点:结果精确、计算极快。
- 缺点:无法处理美式期权(因提前行权导致自由边界问题)。
对于欧式看涨期权,终值条件为:
求解 PDE 得到著名的 Black-Scholes 定价公式:
其中:
$ N(\cdot) $ 为标准正态分布的累积分布函数。
数值方法
当解析解不存在时,使用数值近似。
1. 有限差分法(Finite Difference Method, FDM)
- 核心思想:将连续的 $ (S, t) $ 平面离散化为网格,用差商近似偏导数。
- 求解方向:从到期日 $ t = T $(已知终值)向后倒推至当前时刻 $ t = 0 $。
- 优点:通用性强,可处理美式期权(通过在每步判断是否行权)、时变参数等。
- 缺点:实现较复杂,计算量较大。
2. 二叉树/三叉树模型(Binomial/Trinomial Tree)
- 核心思想:对标的资产价格路径进行离散化建模。
- 每步:$ S \to uS $(上涨)或 $ S \to dS $(下跌),其中 $ u = e^{\sigma \sqrt{\Delta t}}, d = 1/u $
- 定价过程:
- 构建价格树至到期日;
- 在叶节点计算期权 payoff;
- 从后往前,按风险中性概率折现:
其中 $ p = \frac{e^{r \Delta t} - d}{u - d} $
- 优点:直观、天然支持美式期权(每节点比较行权价值与持有价值)。
- 缺点:收敛速度慢,高维问题效率低。
3. 蒙特卡洛模拟(Monte Carlo Simulation)
- 核心思想:基于风险中性定价原理,不直接解 PDE,而是模拟未来路径。
- 步骤:
- 在风险中性测度下模拟 $ N $ 条资产价格路径:
- 计算每条路径到期收益 $ \text{Payoff}_i $
- 估算价格:
- 在风险中性测度下模拟 $ N $ 条资产价格路径:
- 优点:极其灵活,适用于路径依赖期权(如亚式、回望、障碍期权)。
- 缺点:
- 无法直接处理美式期权(因需最优停止决策);
- 收敛速度慢(误差 $ \propto 1/\sqrt{N} $), 需大量模拟路径以保证精度。
- ZZethes Post #270
“他们自己终于会明白,每个人都有充分的自由,又有管够的地上面包,这是不可想象的,因为他们永远不懂得如何分配!他们还将确信自己永远不可能自由,因为反叛者势单力薄、劣性难改,成不了气候。你许诺给他们天国的面包,但是,我再说一遍,在永远不学好、永远不感恩的孱弱人种眼里,那种面包怎能和地上的相比?”
- Aanonymous Post #271
Ray Dalio:
几乎每一次技术繁荣都会先催生泡沫,随后迎来破灭,无论是铁路、工业革命,还是 20 世纪 20 年代末。
回想 20 年代末:电力、制冷技术、电话、收音机、飞机和汽车都在同时涌现。自然而然地,人们渴望投资于这些奇迹。
危险在于,人们往往未能将技术奇迹与投资行为区分开来。一项技术可能确实具有变革性,但如果股票定价过高,或是靠举债购买,最终就会导致崩盘。这就是泡沫形成与破裂背后的机制。
新技术无疑将是伟大的,但我们始终需要追问:它对谁伟大?它能否带来回报?我们是否为这些奇迹付出了过高的代价?
很高兴能与 MasterClass 首席执行官大卫·罗吉尔(David Rogier)以及 @MasterClass 高管项目(Executive Program)的未来成员们探讨这一话题及其他议题。您可以点击此处了解更多关于该项目的信息:https://mstr.cl/MasterClassExecutiveRD
- Aanonymous Post #3
架构设计出问题 软件熵带来的技术债确实难评
- Aanonymous Post #4
软件工程学习纲领
摘要
现代软件工程教育经常以语言、框架和工具为组织单位:JavaScript、React、Spring、Go、Rust、MySQL、Kafka、Kubernetes。这样的学习路径具有较高的短期生产效率,却容易产生一种结构性问题:工程师掌握了大量 API、配置方法和框架惯例,却没有建立足够稳定的、跨语言和跨系统的知识模型。
当技术栈发生变化时,这类知识需要被大规模重建;当业务复杂度超过框架默认模型能够自然处理的范围时,工程师也容易陷入局部修补、抽象失控、状态混乱和依赖扩散。
生成式 AI 进一步放大了这一问题。AI 显著降低了代码生成、API 查询、语法迁移和样板代码生成的成本,但同时降低了项目的可维护性。于是,工程能力的瓶颈正在从:
Can you write the code?转向:
Do you understand what code should exist?
Where should it exist?
What should depend on what?
What is the data model?
What are the invariants?
What is the concurrency model?
What representation should cross the boundary?
1. 软件工程学习的对象不应该是框架本身
前端框架、后端框架、数据库 ORM、RPC 框架、状态管理工具,本质上都是解决特定工程问题的工具。
React 解决 UI 状态到界面结构之间的映射与更新问题。
Spring 处理对象生命周期、依赖组织、Web 请求处理等工程问题。
Kafka 提供一种持久化分布式日志及其消费模型。
PostgreSQL 提供关系数据模型、事务、索引、查询执行以及持久化能力。
它们当然都值得学习。
问题在于:
它们不应该成为整个知识结构的根节点。
框架具有明显的历史性。
某一种框架可能流行十年,也可能几年后被新的抽象取代。
而另一些问题却长期稳定存在:
- 数据如何表示?
- 状态由谁拥有?
- 一个模块应当隐藏什么?
- 两个组件为什么发生依赖?
- 同一个行为如何具有不同实现?
- 同步调用和异步调用有什么区别?
- 内存中的对象如何变成网络上的字节?
- 网络失败以后应该如何恢复?
- 数据如何从原始记录变成业务聚合?
- 程序如何从源代码变成执行中的进程?
- 并发修改如何保持正确性?
- 一个系统如何在节点失效后继续运行?
这些才构成软件工程真正稳定的知识骨架。
因此,一个合理的学习优先级是:
稳定的计算机科学概念
        ↓
软件设计与系统设计概念
        ↓
语言对这些概念的表达机制
        ↓
框架对这些机制的工程封装
        ↓
具体业务实现
而不是:
Framework A
↓
Framework B
↓
Framework C
↓
不断重新学习
2. AI 改变的不是软件工程基本问题,而是实现成本
生成式 AI 对软件开发最大的影响之一,是大量降低了局部实现问题的成本。
例如:
- 编写排序和遍历代码;
- 生成 SQL;
- 编写 JSON 转换;
- 创建 DTO;
- 编写 CRUD;
- 编写 HTTP Client;
- 生成测试样例;
- 将一种语言翻译为另一种语言;
- 查询一个不熟悉的 API;
- 阅读陌生代码;
- 解释框架内部调用链。
这些任务过去需要大量记忆、编码熟练度和搜索能力。
现在越来越多可以交给 AI 完成。
但是有一类问题并没有因此消失:
应该抽象什么?例如:
这个数据应该属于 User 还是 Order?

这个字段应该存储还是计算?

这里应该使用事件还是直接调用?

这个对象应该拥有数据库访问能力吗?

这个缓存是否允许短暂不一致?

这里是否要求事务?

这个操作应该幂等吗?

这个异步任务失败后如何恢复?

业务状态机有哪些非法状态?

一个服务的边界到底在哪里?
AI 可以给出候选答案,但如果工程师没有自己的系统模型,就很难判断这些答案是否成立。
因此,AI 时代反而提高了以下能力的重要性:
Abstraction
Modeling
Decomposition
Invariant Reasoning
Dependency Management
Representation Design
Concurrency Reasoning
Failure Reasoning
换句话说:
AI 降低了代码的生产成本,因此提高了判断“什么代码值得存在”的价值。
3. 软件系统可以统一理解为表示、状态与转换
如果试图寻找前端、后端、数据库、编译器、数据工程之间的共同结构,会发现一个极其稳定的模式:
Representation
    ↓
Transformation
    ↓
Representation
软件系统不断将一种表示转换成另一种表示。
例如,一个 Web 应用可能具有如下数据路径:
HTTP Bytes
↓
UTF-8
↓
JSON
↓
DTO
↓
Domain Model
↓
Business Rules
↓
View Model
↓
DOM
↓
Pixels
数据仓库则可能表现为:
Operational Data
↓
Raw Layer
↓
Staging
↓
Normalized Model
↓
Warehouse
↓
Data Mart
↓
Aggregate
↓
Dashboard
编译器也是如此:
Source Text
↓
Token Stream
↓
AST
↓
IR
↓
Machine Instructions
网络协议同样如此:
Application Object
↓
Serialization
↓
Bytes
↓
Protocol Frame
↓
Packet
↓
Bytes
↓
Deserialization
↓
Application Object
因此,可以把软件工程的一大部分归结为:
Representation Design and Transformation.
这也是为什么数据结构、类型、编码、序列化、数据库、编译原理和 API 设计之间存在比表面上更深的联系。
4. 另一个核心问题:状态属于谁
软件系统的复杂性往往不是来自函数数量,而是来自状态。
任何复杂系统都可以不断追问:
What state exists?

Who owns the state?

Who may mutate it?

When may it change?

Who observes it?

How is consistency maintained?

How is it persisted?

How is it replicated?

What happens after failure?
这组问题横跨整个计算机系统。
在前端中,它表现为:
Component State
Global State
Server State
Derived State
在数据库中,它表现为:
Transaction
Isolation
MVCC
Durability
在操作系统中,它表现为:
Process State
Memory
File Descriptor
Thread State
在分布式系统中,则表现为:
Replicated State
Consensus
Eventual Consistency
Conflict Resolution
因此,对状态的理解应当成为软件工程课程的主线之一。
5. 第三个核心问题:依赖
如果数据和状态决定“系统拥有什么”,依赖则决定“系统如何组织”。
复杂代码最终往往表现为一个依赖图:
A → B → C
    ↓
    D
一个良好的架构,本质上是在控制:
- dependency direction;
- dependency visibility;
- dependency lifetime;
- dependency stability;
- dependency fan-in;
- dependency fan-out。
设计模式也可以从这一视角重新理解。
例如 Strategy 并不首先意味着“创建一个 Strategy 接口”。
它解决的是:
Stable Caller
    ↓
Variable Behavior
通过引入抽象:
Stable Caller
    ↓
Abstraction
    ↓
Implementation A
Implementation B
Adapter 解决的是接口表示不兼容:
Expected Interface
        ↓
      Adapter
        ↓
Existing Interface
Observer 解决的是一对多传播关系:
State Producer
      ↓
    Event
 ↓    ↓    ↓
A     B     C
Dependency Inversion 解决的是依赖方向与实现细节之间的关系。
因此:
设计模式不是应该记忆的代码模板,而是对常见依赖结构、变化结构和协作关系的命名。
6. 为什么设计模式不能成为真正的第一课
传统的软件工程学习经常把设计模式放在非常早的位置。
这存在一个问题。
如果学习者尚未理解:
- module;
- information hiding;
- abstraction;
- interface;
- implementation;
- coupling;
- cohesion;
- composition;
- dependency;
那么设计模式容易退化成模式匹配:
看到 new → Factory

看到不同算法 → Strategy

看到通知 → Observer
这种学习方式最终可能增加而不是降低复杂度。
更合理的依赖顺序应该是:
Module
  ↓
Interface / Implementation
  ↓
Information Hiding
  ↓
Coupling / Cohesion
  ↓
Composition
  ↓
Dependency
  ↓
Change Boundary
  ↓
Design Principle
  ↓
Design Pattern
设计模式只是这一系列概念的后续表达。
7. 语言不是知识边界,而是概念的具体实现
软件工程师当然需要熟悉语言。
但语言更适合作为:
抽象概念的实验环境。
例如“多态”并不属于 Java。
不同语言只是采用不同方式表达多态。
Java:
interface Storage {
    void save(Data data);
}
Go:
type Storage interface {
    Save(Data) error
}
Rust:
trait Storage {
    fn save(&self, data: Data);
}
TypeScript:
interface Storage {
  save(data: Data): void;
}
这些语法不同,但背后的问题相同:
Caller
↓
Stable Contract
↓
Replaceable Implementation
同样,闭包也不是 JavaScript 特有的概念。
JavaScript、Python、Go、Rust、Swift、Kotlin 等现代语言都提供某种形式的闭包。
异步也不是 JavaScript 专属知识。
不同语言可能分别使用:
JavaScript → Promise / async-await
Java       → Future / CompletableFuture
Go         → goroutine / channel
Rust       → Future / async-await
Python     → asyncio
理解这些机制的目标不是记住 API,而是理解:
Task
↓
Suspend
↓
Other Work Executes
↓
Resume
以及它和线程、事件循环、协程、调度器之间的关系。
8. 多语言学习的真正意义
因此,本教材推荐有限度地进行多语言比较。
目的不是“掌握更多语言”,而是识别:
哪些东西属于计算模型,哪些东西只是语言语法。
典型比较维度包括:
概念 TypeScript Java Go Rust 抽象接口 Structural Interface Interface Interface Trait 参数多态 Generic Generic Generic Generic 行为多态 Structural Subtyping Interface Trait 闭包 Closure Lambda Closure Closure 错误 Exception / Value Exception Error Value Result 空值 null / undefined null nil Option 并发 Promise Thread/Future goroutine Future 内存 GC GC GC Ownership 生命周期 Runtime Runtime Runtime Static Lifetime 这样的比较最终帮助学习者形成语言无关的认知:
Concept
↓
Language Mechanism
↓
Library / Framework
9. 数据处理能力是通用工程能力
大量业务程序归根结底都在处理数据。
最基础的数据处理操作实际上非常有限:
map
filter
reduce
group
join
sort
partition
aggregate
这些操作不断以不同形式出现。
JavaScript Array API:
map / filter / reduceSQL:
SELECT
WHERE
GROUP BY
JOIN
ORDER BY
数据框架:
map
filter
groupBy
join
aggregate
分布式数据处理框架:
map
shuffle
reduce
因此,所谓“业务数据处理能力”不应只理解成会写 SQL 或 JSON 转换。
更核心的是能够判断:
输入数据是什么表示?

输出数据需要什么表示?

中间存在什么不变量?

哪些字段是原始事实?

哪些字段是派生结果?

在哪一层应该聚合?

在哪一层应该过滤?

哪些计算应该提前完成?

哪些计算应该延迟到查询阶段?
这实际上连接了:
Data Structure
↓
Data Modeling
↓
Database
↓
Warehouse
↓
Data Architecture
10. 数据必须分层
原始数据直接进入业务和展示层,通常意味着未来的高耦合。
一个稳定系统往往具有多层表示。
典型业务系统:
External Representation
↓
Transport Model
↓
Domain Model
↓
Persistence Model
↓
Query Model
↓
Presentation Model
数据仓库:
Source
↓
Raw
↓
Staging
↓
Warehouse
↓
Mart
↓
Aggregate
↓
Presentation
这些层级不一定全部需要真实存在。
关键思想是:
不同边界需要不同表示。
如果一个对象同时承担:
- 网络协议;
- 数据库结构;
- 业务模型;
- UI 展示;
那么任意一层变化都可能向整个系统传播。
这实际上又回到了设计中的核心问题:
Information Hiding
Boundary
Coupling
Representation
11. 编码与序列化不是边缘知识
软件系统持续跨越各种边界:
Memory
↓
File
↓
Network
↓
Process
↓
Machine
一旦跨越边界,内存中的对象就必须被转换。
典型路径:
Object
↓
Serialization
↓
Bytes
↓
Transport / Storage
↓
Bytes
↓
Deserialization
↓
Object
因此,每一个软件工程师都应该理解:
Character
Code Point
Encoding
Byte
Serialization
Schema
Compatibility
并能够解释:
ASCII
Unicode
UTF-8
UTF-16
Endianness
Integer Encoding
Floating Point
JSON
Protocol Buffers
Avro
MessagePack
进一步还必须理解:
Backward Compatibility
Forward Compatibility
Schema Evolution
因为生产系统中的数据不会随着代码部署自动消失。
12. 操作系统是理解运行时的基础
大量高级框架能力最终建立在操作系统提供的几个核心抽象之上:
Process
Thread
Memory
File
Socket
Scheduler
因此,所谓同步、异步、并发,并不能只停留在:
await someFunction()需要进一步理解:
Process
├── Address Space
├── File Descriptor
└── Threads
线程又涉及:
Thread
├── Scheduling
├── Context Switch
├── Race Condition
├── Mutex
├── Semaphore
├── Condition Variable
└── Atomic Operation
IO 又进一步导向:
Blocking IO
Non-blocking IO
IO Multiplexing
Asynchronous IO
这些机制最终产生不同并发模型:
Thread Pool
Event Loop
Coroutine
Actor
CSP
只有理解这一层,才能真正理解不同语言中的异步机制为什么具有不同性质。
13. 网络是分布式软件的基础运行环境
现代软件几乎不可避免地通过网络协作。
因此,一个工程师不应只知道 HTTP 方法,而应该建立基本协议栈:
Application
↓
HTTP / RPC
↓
TLS
↓
TCP / QUIC
↓
IP
至少需要理解:
DNS
Connection
Socket
Handshake
Timeout
Retry
Keep-Alive
Multiplexing
Congestion Control
Proxy
Reverse Proxy
Load Balancing
尤其重要的是理解:
网络调用与本地函数调用具有根本不同的失败模型。
本地函数调用通常是:
success / failure远程调用则可能出现:
request never arrived

request arrived but response lost

request executed twice

server executed but client timed out

partial network failure

connection reset

retry causes duplicate effect
这正是:
Timeout
Retry
Idempotency
Deduplication
等分布式系统概念产生的基础。
14. 编译原理训练的是表示转换能力
编译原理的长期价值不只体现在“实现编译器”。
它给出了一个非常清晰的复杂系统分层范例:
Source
↓
Lexer
↓
Token
↓
Parser
↓
AST
↓
Semantic Analysis
↓
Intermediate Representation
↓
Optimization
↓
Code Generation
从这个结构中可以理解大量现实软件。
例如:
SQL Parser
GraphQL Parser
Template Engine
Babel
ESLint
TypeScript Compiler
Configuration Language
DSL
它们本质上都包含某种:
Parse
↓
Represent
↓
Analyze
↓
Transform
↓
Emit
因此,学习编译原理不仅是学习 compiler。
它实际上是在训练:
如何设计中间表示,以及如何将复杂问题分解成多个稳定转换阶段。
15. 架构不是模式的堆积,而是约束关系
很多工程师在基础不足时直接学习:
DDD
Clean Architecture
Hexagonal Architecture
CQRS
Event Sourcing
Microservices
容易形成另一个误区:
架构是一组应该套用的高级模板。
事实上,架构更接近:
对大型系统中依赖、状态、数据、边界和变化关系施加长期约束。
因此架构的前置知识应该包括:
Module
+
Abstraction
+
Dependency
+
Data Modeling
+
Persistence
+
Concurrency
+
Network
+
Failure Model
在这些知识之上,才能正确理解:
Layered Architecture
Hexagonal Architecture
Clean Architecture
Event-Driven Architecture
CQRS
Microservices
架构模式最终解决的仍然是前面那些基本问题,只不过作用范围更大。
16. DDD 的本质首先是业务模型边界
领域驱动设计同样不应该从术语开始。
DDD 最重要的问题是:
现实业务中的概念
↓
如何形成稳定的软件模型?
其核心概念:
Ubiquitous Language
Bounded Context
Entity
Value Object
Aggregate
Repository
Domain Service
Domain Event
实际上围绕两个问题展开:
Business Boundary
+
State Invariant
例如 Aggregate 的关键并不是“对象集合”,而是:
哪一组状态需要在一个一致性边界中维护业务不变量?
Bounded Context 的关键也不是目录结构,而是:
某个业务术语在哪一个语义边界内具有唯一而明确的定义?
因此,DDD 依赖于前面已经建立的数据模型、接口、模块、状态和事务知识。
17. 分布式系统是操作系统、数据库和网络的汇合点
分布式系统不是一个孤立课程。
它可以看成三棵知识树的汇合:
Operating Systems
        \
         \
Database ─────→ Distributed Systems
         /
        /
Networking
其核心问题包括:
Replication
Partitioning
Consistency
Consensus
Leader Election
Distributed Transaction
Idempotency
Retry
Timeout
Backpressure
Failure Detection
Eventual Consistency
这些概念共同回答一个问题:
当数据、计算和失败跨越多台机器以后,如何继续维持系统的正确性和可用性?
18. 前端应该位于知识图中的什么位置
前端不是“不值得学习”。
更准确的说法是:
前端框架不是整个软件知识体系的根,而是 Web 平台能力之上的一个专业分支。
基础知识可以向不同领域展开:
                        React / Vue
                       /
Core Knowledge ─── Backend
                       \
                        Data Engineering
                       \
                        Distributed Systems
如果进一步进入高级前端,则仍然存在大量专业知识:
Browser
↓
HTML Parsing
↓
DOM
↓
CSSOM
↓
Style Calculation
↓
Layout
↓
Paint
↓
Composite
以及:
State
↓
Reactive Dependency
↓
Scheduling
↓
Rendering
↓
Reconciliation
还有:
HTTP
↓
Caching
↓
Resource Scheduling
↓
SSR
↓
Streaming
↓
Hydration
这些知识对于简单 CRUD 页面可能收益有限,但对于:
- 大型交互应用;
- 编辑器;
- Web IDE;
- 图形系统;
- 数据可视化;
- 性能工程;
- 跨端基础设施;
- UI Framework;
具有非常高的工程价值。
因此,正确的问题不是:
前端值不值得学?而是:
对于当前问题,应该深入到知识图中的哪一层?
19. 本教材的核心知识 DAG
下面给出整本教材的核心依赖关系。
flowchart TD

    A[离散数学基础] --> B[数据结构]
    A --> C[逻辑与集合]

    B --> D[算法基础]
    B --> E[数据表示]

    C --> F[类型与关系]

    D --> G[复杂度分析]

    E --> H[字节与二进制表示]
    H --> I[字符编码]
    H --> J[序列化]
    J --> K[Schema]
    K --> L[Schema Evolution]

    B --> M[变量与状态]
    M --> N[作用域]
    N --> O[闭包]

    F --> P[类型系统]
    P --> Q[多态]
    P --> R[泛型]
    P --> S[代数数据类型]

    O --> T[高阶函数]
    T --> U[函数组合]
    T --> V[纯函数与副作用]

    Q --> W[接口]
    W --> X[实现]
    W --> Y[抽象]

    Y --> Z[模块]
    Z --> AA[封装]
    AA --> AB[信息隐藏]

    AB --> AC[耦合]
    AB --> AD[内聚]

    AC --> AE[依赖]
    AD --> AE

    AE --> AF[组合]
    AE --> AG[依赖反转]

    AF --> AH[设计原则]
    AG --> AH

    AH --> AI[设计模式]

    AI --> AJ[Strategy]
    AI --> AK[Adapter]
    AI --> AL[Observer]
    AI --> AM[Decorator]
    AI --> AN[Factory]
    AI --> AO[Command]
    AI --> AP[State]
    AI --> AQ[Composite]

    B --> AR[数据建模]
    F --> AR

    AR --> AS[实体与值对象]
    AR --> AT[关系模型]
    AT --> AU[关系代数]
    AU --> AV[SQL]

    AV --> AW[Join]
    AV --> AX[Aggregation]
    AV --> AY[Window]

    AT --> AZ[数据库存储]
    AZ --> BA[Index]
    AZ --> BB[Query Execution]

    AV --> BC[Transaction]
    BC --> BD[ACID]
    BC --> BE[Isolation]
    BE --> BF[MVCC]

    AR --> BG[数据分层]
    BG --> BH[ETL / ELT]
    BH --> BI[Data Warehouse]
    BI --> BJ[Data Mart]
    BJ --> BK[Analytics Model]

    M --> BL[进程]
    BL --> BM[线程]
    BM --> BN[并发]

    BN --> BO[Race Condition]
    BO --> BP[Mutex]
    BO --> BQ[Atomic]
    BP --> BR[Condition Variable]
    BP --> BS[Semaphore]
    BP --> BT[Deadlock]

    BL --> BU[虚拟内存]
    BL --> BV[文件系统]

    BV --> BW[IO]
    BW --> BX[Blocking IO]
    BW --> BY[Non-blocking IO]
    BY --> BZ[IO Multiplexing]
    BZ --> CA[Event Loop]

    BN --> CB[Coroutine]
    BN --> CC[Actor]
    BN --> CD[CSP]

    CA --> CE[Async/Await]
    CB --> CE

    H --> CF[机器指令]
    CF --> CG[汇编]
    CG --> CH[目标文件]
    CH --> CI[Linking]
    CI --> CJ[Executable]
    CJ --> BL

    I --> CK[Source Text]
    CK --> CL[Lexer]
    CL --> CM[Token]
    CM --> CN[Parser]
    CN --> CO[AST]
    CO --> CP[Semantic Analysis]
    CP --> CQ[IR]
    CQ --> CR[Optimization]
    CR --> CS[Code Generation]
    CS --> CF

    BW --> CT[Socket]
    CT --> CU[TCP]
    CU --> CV[TLS]
    CV --> CW[HTTP]
    CU --> CX[QUIC]
    CX --> CY[HTTP/3]

    CW --> CZ[RPC]
    CW --> DA[Web Architecture]

    BC --> DB[Persistence]
    AE --> DC[Architecture Boundary]
    DB --> DC

    DC --> DD[Layered Architecture]
    DC --> DE[Hexagonal Architecture]
    DC --> DF[Clean Architecture]

    AS --> DG[Domain Modeling]
    BC --> DG
    DC --> DG

    DG --> DH[DDD]
    DH --> DI[Bounded Context]
    DH --> DJ[Aggregate]
    DH --> DK[Domain Event]

    CU --> DL[Distributed Failure Model]
    BC --> DL
    BN --> DL

    DL --> DM[Distributed Systems]

    DM --> DN[Replication]
    DM --> DO[Partitioning]
    DM --> DP[Consistency]
    DM --> DQ[Consensus]
    DM --> DR[Leader Election]
    DM --> DS[Idempotency]
    DM --> DT[Retry]
    DM --> DU[Timeout]
    DM --> DV[Backpressure]

    DN --> DW[Eventual Consistency]
    DO --> DW

    DK --> DX[Event-Driven Architecture]
    DM --> DX

    DG --> DY[CQRS]
    DX --> DY

    DM --> DZ[Microservices]
    DC --> DZ

    DA --> EA[Browser Architecture]
    EA --> EB[DOM]
    EA --> EC[CSSOM]
    EB --> ED[Layout]
    EC --> ED
    ED --> EE[Paint]
    EE --> EF[Composite]

    M --> EG[UI State]
    EG --> EH[Reactive System]
    EH --> EI[Scheduler]
    EI --> EJ[Rendering]
    EJ --> EK[Reconciliation]

    CW --> EL[Caching]
    DA --> EM[SSR]
    EM --> EN[Streaming]
    EN --> EO[Hydration]
20. DAG 的主干
如果去掉支线,整个课程可以进一步压缩成七条主链。
20.1 软件设计链
变量
↓
函数
↓
作用域
↓
闭包
↓
类型
↓
接口
↓
抽象
↓
模块
↓
封装
↓
信息隐藏
↓
耦合 / 内聚
↓
依赖
↓
组合
↓
设计原则
↓
设计模式
↓
架构
20.2 数据链
数据结构
↓
数据表示
↓
数据建模
↓
关系模型
↓
SQL
↓
事务
↓
索引
↓
查询执行
↓
数据分层
↓
数据仓库
↓
分布式数据系统
20.3 数据表示链
Bit
↓
Byte
↓
Integer
↓
Floating Point
↓
Character
↓
Unicode
↓
UTF-8
↓
Serialization
↓
Schema
↓
Schema Evolution
↓
Protocol
20.4 系统链
Machine Instruction
↓
Process
↓
Virtual Memory
↓
Thread
↓
Concurrency
↓
Synchronization
↓
IO
↓
Socket
↓
Network
20.5 编程语言链
Source Text
↓
Lexer
↓
Token
↓
Parser
↓
AST
↓
Semantic Analysis
↓
IR
↓
Machine Code
↓
Runtime
20.6 分布式系统链
Network
+
Concurrency
+
Database
↓
Distributed Failure
↓
Replication
↓
Partition
↓
Consistency
↓
Consensus
↓
Distributed Architecture
20.7 业务架构链
Data Modeling
↓
Invariant
↓
Domain Model
↓
Transaction Boundary
↓
Bounded Context
↓
Domain Event
↓
Architecture
↓
Complex Business System
21. 推荐的教材拓扑序
DAG 不要求只有一种学习顺序。
但对于大多数软件工程师,可以使用下面这一拓扑排序:
01 数据结构
02 变量与状态
03 函数
04 作用域
05 闭包
06 类型
07 多态
08 泛型
09 接口与实现
10 抽象
11 模块
12 封装
13 信息隐藏
14 耦合与内聚
15 组合
16 依赖
17 设计原则
18 设计模式
19 数据表示
20 字节
21 Unicode / UTF
22 序列化
23 数据建模
24 关系模型
25 SQL
26 Join
27 Transaction
28 Index
29 Query Execution
30 Process
31 Virtual Memory
32 Thread
33 Race Condition
34 Lock
35 Atomic
36 Deadlock
37 IO
38 Event Loop
39 Coroutine
40 Async/Await
41 Socket
42 TCP
43 TLS
44 HTTP
45 Lexer
46 Parser
47 AST
48 Interpreter
49 Compiler
50 Data Layering
51 Data Warehouse
52 Distributed Failure
53 Replication
54 Partition
55 Consistency
56 Consensus
57 Idempotency
58 Retry
59 Backpressure
60 Architecture Boundary
61 Layered Architecture
62 Hexagonal Architecture
63 DDD
64 Bounded Context
65 Aggregate
66 Domain Event
67 Event-Driven Architecture
68 CQRS
69 Microservices
70 Browser Architecture
71 Rendering Pipeline
72 Reactive System
73 Scheduler
74 SSR
75 Streaming
76 Hydration
这 76 个节点已经足以形成一套相当完整的软件工程基础教材。
22. 每个章节只讨论一个概念
本教材应该刻意避免传统教材常见的问题:
一个章节同时引入五到十个新概念。
对于 AI 辅助学习而言,更合适的粒度是:
One Chapter
=
One Concept
例如:
Chapter 17: Coupling只解释 coupling。
下一章:
Chapter 18: Cohesion只解释 cohesion。
之后:
Chapter 19: Dependency再讨论 dependency。
这样做有几个明显优势。
第一,每个概念都可以单独检索、复习和重新生成。
第二,可以明确记录概念的 prerequisites。
第三,可以让 AI 针对某个知识节点反复采用不同语言、不同案例解释。
第四,可以执行知识图谱意义上的拓扑学习,而不是被一本教材固定的章节顺序绑定。
23. 每章统一使用同一个知识模板
建议所有概念章节采用统一结构。
# Concept Name

## 1. Definition

这个概念是什么?

## 2. Motivation

它解决什么问题?

## 3. Problem Without It

如果没有这个概念,会发生什么?

## 4. Minimal Model

给出该概念最小化的形式模型。

## 5. Mechanism

它内部如何工作?

## 6. Invariants

必须始终保持什么条件?

## 7. Example

给出最小业务例子。

## 8. Cross-Language Comparison

分别使用 TypeScript / Go / Java / Rust 表达。

## 9. Common Misconceptions

最常见的误解是什么?

## 10. Failure Modes

在工程实践中通常如何出错?

## 11. Related Concepts

与哪些概念横向关联?

## 12. Prerequisites

学习这个概念之前应该掌握什么?

## 13. Next Concepts

下一步应该学习什么?

## 14. Exercises

提供推理题,而不只是编码题。
24. AI 学习 Prompt 协议
因此,可以将每一个 DAG 节点直接提交给 AI。
推荐固定 Prompt:
你正在给我编写一本面向资深软件工程师的极简教材。

当前概念:

<CONCEPT>

请严格只围绕这个概念讲解。

要求:

1. 给出严格但工程可理解的定义。
2. 解释它试图解决什么问题。
3. 解释没有这个概念时系统会出现什么问题。
4. 建立最小形式模型。
5. 解释底层机制,而不是只描述 API。
6. 列出关键 invariant。
7. 给一个最小真实业务案例。
8. 如果适用,分别使用 TypeScript、Go、Java、Rust 表达。
9. 比较不同语言为什么采用不同实现。
10. 列出常见误区。
11. 列出真实工程中的 failure modes。
12. 明确列出 prerequisites。
13. 明确列出 next concepts。
14. 给出 3 道概念推理题。
15. 不引入尚未出现在 prerequisites 中的新概念;如果必须使用,先给出最小定义。

写作风格:
学术、技术、紧凑、避免营销语言和无意义类比。
这样整本教材实际上可以被定义成:
DAG
+
Chapter Template
+
AI Generator
25. 教材不应该测试 API 记忆
传统技术面试和技术教育常常过度关注:
某 API 的参数是什么?
某框架生命周期是什么?
某个配置应该写在哪里?
AI 已经显著降低了这类记忆的价值。
本教材更应该测试:
为什么?

什么时候?

有什么不变量?

失败会怎样?

边界在哪里?

数据属于谁?

状态属于谁?

谁依赖谁?

表示为什么这样设计?

另一个方案有什么 trade-off?
例如,不应该主要考:
Promise.all怎么用?而应该考:
三个异步任务是否具有依赖关系?
是否允许部分失败?
是否需要限制并发?
是否具有幂等性?
调用方取消以后任务是否应该继续?这才是可迁移的工程能力。
26. 算法应该占据什么位置
算法仍然重要,但对于大多数业务软件工程师,其学习目的已经发生变化。
不一定要求重复实现所有经典算法。
更重要的是理解:
Time Complexity
Space Complexity
Hashing
Tree
Heap
Graph
Index
Search
Sort
Dynamic Programming
并能够判断:
这个问题属于哪一类计算问题?

数据规模是多少?

复杂度会如何增长?

是否存在更合适的数据结构?
因为具体实现已经越来越容易由标准库或 AI 提供。
但如果连:
O(n)
O(log n)
O(n log n)
O(n²)
都缺乏直觉,则仍然无法判断 AI 生成的程序是否合理。
27. AI 不应该替代系统模型
未来大量代码可能不会由人逐行编写。
但这并不意味着软件工程知识的重要性下降。
更可能发生的是:
Human
↓
Model / Constraint / Architecture
↓
AI
↓
Code
人的角色逐渐从:
statement author转向:
system modeler
constraint designer
architecture reviewer
failure analyst
因此,高水平工程师的核心问题不再只是:
我能不能实现?而是:
我能不能验证实现?而验证需要依赖完整的心智模型。
如果工程师不知道:
- transaction isolation;
- event ordering;
- ownership;
- lifetime;
- idempotency;
- data invariant;
- module boundary;
那么即使 AI 生成的代码能够编译,也很难判断它是否真正正确。
28. 最终学习目标:读懂陌生系统
本教材的最终目标并不是让学习者记住几十个设计模式或者掌握几十种工具。
理想状态是:
面对一个从未见过的大型系统,仍然能够迅速建立其内部模型。
进入一个陌生代码库时,可以主动寻找:
Data Model
State
Control Flow
Dependency Graph
Module Boundary
Persistence Boundary
Concurrency Model
Failure Model
External Interface
Representation Transformation
例如第一轮阅读可以只回答:
核心数据有哪些?

核心状态在哪里?

入口在哪里?

数据从哪里进来?

经过哪些 transformation?

在哪里持久化?

哪些模块拥有副作用?

异步边界在哪里?

错误在哪里被处理?

哪些组件依赖外部系统?
第二轮再继续识别:
抽象是否合理?

依赖方向是否稳定?

是否存在循环依赖?

是否混合了多个业务边界?

是否存在重复状态?

数据表示是否泄漏?

事务边界是否正确?

并发访问是否安全?
一旦具备这些能力,语言和框架迁移就会变得明显容易。
面对陌生语言,需要寻找的只是:
这里如何表达 interface?

如何表达 generic?

如何表达 closure?

如何处理 error?

如何执行 async?

如何管理 resource?

如何组织 package / module?
面对陌生框架,则进一步寻找:
生命周期在哪里?

状态模型是什么?

依赖注入在哪里?

IO 边界在哪里?

调度器在哪里?

扩展点在哪里?
这与重新学习整个软件工程是完全不同的难度。
29. 一个更抽象的软件工程知识模型
最终,我们可以将本书几乎所有概念进一步压缩成九个基本问题:
Data
State
Representation
Transformation
Boundary
Dependency
Control Flow
Concurrency
Failure
任何复杂系统都可以沿这九个维度进行分析。
Data
系统处理什么事实?
State
哪些事实随时间变化?
Representation
这些事实以什么形式存在?
Transformation
一种表示如何变成另一种表示?
Boundary
哪些东西属于同一个模块或一致性范围?
Dependency
谁知道谁?
谁依赖谁?
Control Flow
谁调用谁?
控制权如何传播?
Concurrency
哪些事情可能同时发生?
Failure
当其中一部分失败时,系统如何表现?
30. 软件工程的统一视角
于是,前端:
State
+
Transformation
+
Rendering
后端:
Boundary
+
Dependency
+
Persistence
数据库:
Data
+
State
+
Consistency
数据工程:
Representation
+
Transformation
+
Aggregation
操作系统:
State
+
Resource
+
Concurrency
编译器:
Representation
+
Transformation
+
Semantics
分布式系统:
State
+
Concurrency
+
Failure
架构:
Boundary
+
Dependency
+
Evolution
看起来不同的领域,实际上反复研究的是同一组基本问题。
31. 本书的基本立场
因此,本教材采用以下原则。
第一:
不以框架作为知识结构的根。
第二:
不以语言作为知识边界。
第三:
不把设计模式当作代码模板。
第四:
不把数据处理理解为简单的数据搬运。
第五:
不把异步理解为 async/await 语法。
第六:
不把数据库理解为 SQL API。
第七:
不把编译原理理解为编译器开发专属知识。
第八:
不把架构理解为架构图。
第九:
不把 AI 生成的代码等同于已经理解的代码。
32. 应该建立什么样的工程直觉
一个成熟的软件工程师应该逐渐形成一些近乎自动化的判断。
看到对象时问:
它代表什么数据?看到字段时问:
它是事实还是派生状态?看到类时问:
它真正隐藏了什么?看到接口时问:
这里为什么需要替换实现?看到模块时问:
边界为什么画在这里?看到异步时问:
谁在调度?谁可能同时发生?看到网络请求时问:
失败以后发生什么?看到数据库写入时问:
事务边界在哪里?看到消息队列时问:
是否可能重复?
顺序是否重要?
看到缓存时问:
允许多长时间不一致?看到数据转换时问:
为什么需要新的 representation?看到设计模式时问:
它控制的到底是哪一种变化?看到 AI 代码时问:
它维持了哪些 invariants?这些问题比记忆任何一个框架的 API 都更具有长期价值。
33. 结语:知识应该形成图,而不是列表
软件工程知识并不是:
Java
React
Redis
Kafka
Docker
Kubernetes
这样的技术名词列表。
它更接近一个概念网络:
             abstraction
            /           \
       interface       module
          |              |
     dependency       boundary
          \              /
            architecture
                 |
               system
另一个方向:
data
↓
representation
↓
transformation
↓
storage
↓
transaction
↓
replication
↓
distributed state
还有:
process
↓
thread
↓
concurrency
↓
IO
↓
network
↓
distributed system
当这些知识逐渐连接起来以后,工程师会发现:
很多看似新的技术,实际上只是旧问题的一种新组合。
一个新的状态管理框架可能重新组合:
State
Dependency
Observer
Scheduler
一个新的后端框架可能重新组合:
Module
Dependency Injection
HTTP
Serialization
Persistence
一个新的分布式数据库可能重新组合:
Storage
Replication
Partition
Consensus
Transaction
一个新的 AI Agent Framework 可能重新组合:
State
Workflow
Event
Tool Interface
Serialization
Retry
Persistence
因此真正具有长期复利的学习方式,不是不断追逐技术名称。
而是不断增加自己能够识别的底层概念。
最终理想状态是:
New Technology
↓
Recognize Existing Concepts
↓
Locate Novel Mechanism
↓
Understand Trade-offs
↓
Use It
而不是:
New Technology
↓
Start From Zero
这就是本教材试图建立的软件工程学习体系。
Appendix A — 推荐核心教材
软件设计
John Ousterhout — A Philosophy of Software Design
重点:
- Complexity
- Deep Module
- Information Hiding
- Interface
- General-Purpose Module
Martin Fowler — Refactoring
重点:
- Code Smell
- Refactoring
- Responsibility
- Change Boundary
Gamma et al. — Design Patterns
不建议机械背诵全部模式。
优先:
Strategy
Adapter
Observer
Decorator
Factory
Command
State
Composite
Proxy
Facade
Appendix B — 系统基础
Computer Systems: A Programmer's Perspective
重点:
Data Representation
Machine Code
Memory
Linking
Process
Virtual Memory
IO
Concurrency
Operating Systems: Three Easy Pieces
重点:
Virtualization
Concurrency
Persistence
Computer Networking: A Top-Down Approach
重点:
Application Layer
Transport Layer
Network Layer
Appendix C — 数据系统
Database System Concepts
重点:
Relational Model
Relational Algebra
Index
Transaction
Query Execution
Designing Data-Intensive Applications
重点:
Data Model
Storage
Replication
Partition
Transaction
Batch
Stream
Distributed Systems
这本书尤其适合已经具有一定工程经验后反复阅读。
Appendix D — 编程语言与编译
Crafting Interpreters
重点:
Lexer
Parser
AST
Interpreter
VM
GC
如果希望进一步理解类型系统,可以继续:
Types and Programming Languages
Appendix E — 领域与架构
DDD 建议首先阅读:
Domain-Driven Design Distilled
然后再阅读:
Domain-Driven Design
重点不是模式名称,而是:
Business Model
Language
Boundary
Invariant
Consistency
Appendix F — 整套教材的最小核心书单
如果只允许选择五本:
A Philosophy of Software Design
↓
Computer Systems: A Programmer's Perspective
↓
Operating Systems: Three Easy Pieces
↓
Designing Data-Intensive Applications
↓
Crafting Interpreters
它们分别回答:
软件应该如何组织?
计算机如何执行软件?
运行中的系统如何工作?
数据系统如何工作?
编程语言如何工作?
这五个问题构成理解现代软件系统的一条极强主干。
Appendix G — 最终原则
可以将整套方法压缩为一句话:
学习软件工程时,应优先掌握跨语言、跨框架、跨业务长期稳定的概念,并将语言与框架理解为这些概念在具体计算环境中的实现。
进一步压缩:
Learn concepts.
Model systems.
Understand boundaries.
Control dependencies.
Understand data.
Reason about state.
Reason about failure.
Use languages as tools.
Use frameworks as tools.
Use AI as an implementation amplifier.
最终目标不是成为某一个框架的熟练使用者。
而是:
面对陌生语言、陌生框架、陌生代码库和陌生业务时,仍然能够快速恢复其数据模型、状态模型、依赖结构、控制流、并发模型与失败模型,并在此基础上安全地修改系统。
这才是一套能够跨越技术周期的软件工程能力。
- Aanonymous Post #1
价值投资、时代与人生
AIGC 整理讲稿
根据 2019 年、2024 年北大讲座及现场问答整理,非本人原文
这些年来,我常常会碰到一个问题:价值投资的基本原理似乎并不复杂,讲来讲去,也就是那么几个概念。既然道理并不难懂,为什么真正能够长期按照价值投资的方法去实践的人,却始终只是很少的一部分?我自己做投资这么多年以后,越来越觉得,这其实就是“知”和“行”之间的距离。价值投资首先是一种思想方法,但它最终一定要落实到实践;而一旦进入实践,人性、环境、激励机制、市场波动、别人对你的看法,包括你自己对自己的认识,都会不断地来考验这些看起来非常简单的原则。所以真正难的地方,从来不是把几个概念背下来,而是在几十年的时间里,当环境不断变化、市场不断诱惑你、别人不断告诉你还有更聪明的办法时,你仍然能够按照自己真正理解的规律去行动。
我第一次真正系统接触价值投资,是三十多年前刚刚到美国以后。那个时候,我并没有想到自己后来会做投资这么多年,也没有想到这会变成影响我一生的一套思想方法。后来回过头来看,我越来越觉得,价值投资对我的意义远远超出了投资本身。它首先教会我如何理解一家企业,后来又逐渐逼着我去理解市场经济、理解制度、理解历史、理解人的心理,最后还必须不断地理解自己。投资表面上是在分配资本,实际上它是一场非常漫长的求知过程。你在这个过程中不断发现自己原来不知道什么,不断修正过去的错误,同时又逐渐建立起少量真正可靠的知识。对我来说,这可能才是价值投资最有意思的地方。
如果一定要把价值投资最基本的思想讲清楚,我一直认为其实只有四个最根本的概念。第一个概念是,股票本质上代表的是一家企业的所有权;第二个概念是,市场存在是为了给你服务,而不是为了指导你;第三个概念是,我们投资所面对的是未来,而未来本质上是不确定的,所以任何判断最终都只能是概率,正因为如此,我们必须要求安全边际;第四个概念是,投资人必须通过长期学习,逐渐建立属于自己的能力圈,并且只在能力圈范围之内行动。听起来,这四个概念并没有多复杂,甚至一个下午就可以解释清楚。但价值投资真正的全部困难,其实都藏在这四句话真正落实到现实生活之后发生的事情里面。
一、股票首先是一种所有权,而不是一个每天跳动的价格
很多人进入股票市场以后,第一个看到的是价格。今天涨了多少,明天跌了多少,市场怎么看,机构怎么看,分析师怎么看,新闻在说什么,这些东西非常容易占据一个人的全部注意力。但是价值投资的第一个要求,是在心理上把这个关系倒过来:你首先买的是企业,然后才是股票。如果你买了一家公司百分之一的股份,和你买了一家公司百分之百的股份,在经济本质上并没有根本区别。差别只在于你的所有权比例不同,而不是一种叫作“企业”,另一种叫作“股票”。
我自己早年真正开始投资以后,对这个问题有过一个很深的心理体验。当时我对生意其实还懂得非常少,最开始能够做的事情,不过是读财务报表,尤其是资产负债表。我会去看那些非常便宜的股票,看公司账上到底有多少现金、多少证券、多少房地产,看看它的净资产和市场价格之间到底是什么关系。有一些公司的市场价值甚至明显低于账面上可以相对可靠确认的资产价值。那个时候我对企业未来到底能够赚多少钱,往往并不十分清楚,但是因为价格足够低,我觉得至少有一层比较大的保护,所以敢于开始做一些投资。
真正有意思的变化发生在买完以后。当一家公司只是一个研究对象的时候,你和它之间的心理关系是一种关系;当你真正拿自己的钱买下它的一部分以后,这种关系会立刻发生变化。我第一次清楚地意识到:这家公司有一部分真的属于我。这个时候,你开始用一种所有者的心态重新看待所有信息。以前只是看一个数字,现在你会问这个数字是怎么来的;以前看到收入增长,也许就觉得不错,现在你会继续追问这个收入靠什么产生,它是不是可持续,客户为什么要买它的东西,竞争对手能不能把这个生意抢走,公司的资本为什么这样配置。你甚至会开始关心一个以前完全不会注意的问题:如果这个企业是我百分之百拥有,而且股票市场从今天开始十年不开门,我还愿不愿意继续持有它?
这种心理转换非常重要,因为一个人的屁股和脑袋在很大程度上确实是连在一起的。比如一个长期从事卖方研究的人,他的工作激励就是把一个观点卖出去,那么他自然会不断寻找支持自己观点的信息。如果你天天训练自己怎么把一个故事讲得更漂亮,最后最大的危险不是别人被你说服,而是你自己被自己说服。一个特别会“卖”观点的人,如果不能完成从销售者思维到所有者思维的转变,在投资上反而可能遇到很大的问题。真正成为所有者以后,你搜集信息的“天线”会发生变化,过去的知识仍然有用,但是知识之间的组织方式变了,因为你的目标不再是证明一个观点足够精彩,而是判断自己的钱放在这个企业里到底安不安全。
所以我始终认为,“股票是所有权”并不是一句抽象的金融学定义,它首先是一种很重要的心理训练。如果没有完成这个心理转换,后面所有的价值投资方法都很难真正建立起来。一个把股票当作交易代码的人和一个把股票当作企业所有权的人,即使看的是同一份年报,得到的信息也会非常不一样。前者更容易问下个月股价会不会涨,后者则会自然地问,这个企业十年以后会是什么样子。时间尺度一变,信息的意义也就变了。
二、投资和投机,看起来都在买卖股票,实际上是在玩两种完全不同的游戏
理解了所有权以后,第二个必须想清楚的问题,就是股票市场里面到底有哪些人在做什么。股票市场从诞生开始,其实一直混合着两种完全不同的行为。一种行为是在判断企业未来的经济表现,也就是说,公司以后能够赚多少钱,能够创造多少价值;另一种行为是在判断其他市场参与者短期内会怎么行动,也就是说,别人明天愿意出什么价格,过几个月情绪会不会更乐观,某个资金是不是要进来,下一批买家会不会愿意出更高的价钱。
前一种行为我叫投资,后一种行为本质上就是投机。投资人的研究对象主要是企业,投机人的研究对象主要是其他参与者。虽然两类人最后都可能通过股票买卖表现出来,但这两件事在经济学意义上的结果完全不同。一个企业如果处在能够长期累进增长的现代经济体系里面,它的利润可能持续增加,资本可能不断产生新的回报,所以企业所有者总体上是可以一起变得更加富有的。这是一种可以创造增量的游戏。但是如果你的盈利完全来自于预测另外一个人什么时候买、什么时候卖,那么你赚的钱最终就来自另一个市场参与者的损失。把所有这类行为加在一起,投机本质上就是一个零和的体系;再加上交易成本、管理费用、税收以后,整体甚至会进一步变成负和。
这并不是说投机者在任何一段时间都一定赚不到钱。完全不是这个意思。市场里面当然可能有人连续很多年做得非常好,也有人可能长期处在另一边。但是从整个体系看,如果一个行为并没有创造企业利润,没有增加企业经济价值,而只是参与者之间重新分配筹码,那么最终不可能所有人都靠这个方式获得持续的财富增长。这个道理其实非常简单,但现实中反而经常被各种复杂的名词遮住。有些理论看上去很高级,过去可能讲 K 线,后来讲各种量化模型,再后来可以讲人工智能,但你最后还是要问那个最基本的问题:这套方法赚的钱到底来自哪里?如果主要来自预测其他参与者的短期动作,那么不管包装得多么复杂,本质仍然属于同一类游戏。
这一点为什么重要?因为一个真正的价值投资人进入市场以后,会面对极大的心理压力。你的交易对手绝不是格雷厄姆寓言里一个看上去有点可笑的“市场先生”,现实中的交易对手可能比你学历高,比你有钱,比你有经验,比你职位高,甚至在很长一段时间里,他的业绩都比你好。如果你没有把投资和投机这两个游戏在逻辑上彻底区分开,你就会不断怀疑自己:是不是别人知道的东西比我多?是不是别人赚钱就是别人更正确?是不是我没有参与某一轮上涨,就说明我错过了时代?
一个投资人最容易犯的错误之一,就是不断地觉得自己在“错过”。别人赚了一笔钱,自己没有参与,心理上就开始不舒服。市场不断上涨的时候,原来你认为不属于自己能力圈的东西,也突然变得好像可以理解了;市场不断下跌的时候,原来你已经研究了很多年的企业,又突然变得好像什么都不确定了。归根到底,这是因为你并没有真正站稳自己所玩的游戏。如果你的回报来自企业长期创造价值,那么你的判断体系应该围绕企业建立;如果你的回报来自下一位买家的行为,那当然就要每天研究别人。但是你不能嘴上说自己是投资者,心里却一直在等待市场替自己证明。
三、“市场先生”的真正意义,是让市场给你报价,而不是让市场替你思考
格雷厄姆讲“市场先生”,本来就是为了帮助投资人建立这样一种独立性。你可以把市场想象成一个每天都来敲门的人,他非常勤快,而且精力旺盛,每天都愿意给你报一个价格。有的时候他特别乐观,认为未来什么问题都不存在,于是愿意用非常高的价格买下你手里的资产;另外一些时候,他又会突然非常悲观,觉得未来没有希望,于是愿意用很低的价格把他的资产卖给你。你没有义务每天跟他交易,更没有义务每天接受他的判断。绝大部分时间,你完全可以不理他,只有当他的报价真正变得对你有利的时候,你才需要利用他。
但是这个概念一旦从教室进入现实,难度立刻增加。学生在课堂里听“市场先生”,觉得这是一个非常自然的道理;进入金融市场以后,周围的人却都是真实而具体的,而且常常看起来比自己更加成功。领导可能告诉你,市场已经证明你错了;同事可能因为买了另一类股票而短期获得很好的回报;新闻媒体也会不断把价格变化解释成某种必然的基本面事实。你如果长期处在这种环境里,而自己又没有真正建立独立判断,很容易慢慢把市场价格当成了价值本身,最后从“市场为我服务”变成“市场每天在给我上课”。
所以一个价值投资人必须真正理解,价格和价值是两个概念。价格是某一个时点上市场参与者共同作用形成的结果,价值则是一个企业未来能够创造的经济结果经过合理判断以后得到的估计。我们当然不可能精确知道价值,但不能因为无法精确知道,就把价格当成价值。反过来,如果一家企业的基本面没有发生实质变化,而你只是因为股价下跌就立刻改变自己对它的看法,那通常说明你原来的判断很可能就没有真正独立存在过。
当然,独立绝不等于固执。市场价格有时候可能是在提醒你某些自己没有看到的事实,所以你永远应该去检查自己的逻辑。但是检查逻辑和服从价格完全是两回事。真正的独立性不是“别人说什么我都不听”,而是无论别人说什么,你最终都回到事实和逻辑本身。如果别人提出了你没有考虑过的事实,你就应该认真修改自己的判断;如果只是因为别人比你有地位、比你赚钱多、市场价格和你相反,你就放弃原来的研究,那么你的所谓能力圈就没有真正建立起来。
四、能力圈最关键的不是大小,而是边界
如果一个人不想做投机,而是真正希望通过研究企业的基本面来投资,那么下一步一定会遇到能力圈的问题。什么叫我真正理解一家企业?我怎样知道自己是真的懂,而不是只是觉得自己懂?这可能是投资里面最难的问题之一,因为世界上最危险的无知,不是你知道自己不知道,而是你以为自己已经知道。
我对能力圈的理解,首先不是“你知道多少”,而是“你能不能清楚地画出边界”。任何一个人的知识都是有限的,能力圈当然也一定有限。如果一个人说自己什么行业都懂,什么生意都可以判断,那他大概率其实没有真正理解能力圈。真正的知识一定包含一个条件:你不仅要知道在什么情况下自己的判断成立,还要知道在什么情况下它会失败;不仅要知道为什么这个企业可能很好,还要知道什么事情出现以后,会证明你原来的理解是错误的。
我们做投资,本质上要对企业未来相当长时间的经济表现做判断。那什么才算比较接近“懂”?至少你应该能够回答很多基本问题:这个企业到底靠什么赚钱?客户为什么愿意购买它的产品?竞争对手为什么没有把它的利润抢走?这个行业的基本竞争规则是什么?资本在这里是怎么配置的?管理层到底起到多大作用?十年以后这个企业可能变成什么样?尤其重要的是,你能不能想清楚十年以后它最坏可能是什么样。如果我无法对一家公司的长期下行风险形成比较可靠的判断,我通常就不会轻易说自己真正懂这家公司。
很多人喜欢研究最好的情况,因为最好情况容易让人兴奋。但是投资首先是一个关于风险控制的活动。好的企业有时候会自己照顾好最好的一面,真正危险的是你没有看清最坏的一面。所以能力圈并不是一个鼓励自信的概念,恰恰相反,它首先要求谦卑。你知道得越多,往往越清楚世界上还有多少东西说不清楚。到最后你会发现,绝大多数企业其实你都没有办法真正预测,绝大多数技术变化也很难长期预测,很多今天看起来非常优秀的公司,其竞争优势并没有强到足以跨越很长时间。
我很喜欢芒格讲过的一个标准:如果我要拥有一个观点,我必须首先能够找到最聪明的反对者,并且能够把他的论证讲得足够好,甚至比他本人讲得还好,然后我才有资格真正拥有自己的观点。这个标准的实质就是知识上的诚实。你必须主动去寻找最强的反方,而不是只寻找支持自己的证据。人在心理上天然具有确认偏误,一旦喜欢上一家公司,就会自动多看好消息,少看坏消息;一旦买了股票,更容易把所有信息重新解释成有利于自己的故事。所以能力圈最终不只是知识问题,也是一种人格上的训练。
五、投资真正重要的不是懂得多,而是你真正懂的那一点不能错
世界上的上市公司非常多,如果把全球主要市场加在一起,大概有数以万计甚至十万量级的公司。一个投资人如果把目标设定为“我要全部了解”,从一开始方向就错了。你根本不需要了解所有企业。事实上,一个投资人一生真正需要做出的重大判断非常有限,在任何一个时期,真正值得你深入研究并且可能实际行动的企业,也许只有几家或者十几家。
因此,投资最重要的工作之一其实是做减法。这个行业我看不懂,可以放弃;那个技术变化太快,无法可靠预测,可以放弃;另外一家企业虽然很优秀,但是价格已经没有安全边际,也可以等待。一个投资人完全不需要因为错过了不属于自己的机会而焦虑。真正需要担心的是,当一个明确落在你能力圈里的机会出现时,你有没有把它搞错。
很多人进入投资行业以后会产生一种错误的竞争意识,好像知道得越多就越厉害。其实投资回报并不是知识竞赛。真正赚钱并不要求你在所有领域都比别人聪明,而是要求你在少数真正重要的判断上正确。如果一件事情已经超出了你的能力范围,不做判断往往就是最好的判断;如果一家公司变化太快,以至于十年以后几乎无法想象,那么无论这个故事今天有多吸引人,它也未必是适合你的投资对象。
这也是为什么我越来越愿意把时间集中到那些相对更加可预测的行业和企业里。时间越长,行业本身的基本特征往往比短期的管理技巧更重要。某些行业天然容易形成稳定竞争格局,某些行业则注定长期处在非常激烈的竞争里。比如餐馆,任何一个时期都可能有一批非常成功的餐馆,甚至在某个菜系里做到最好,但是过几年以后名单可能完全变了。这说明“今天很好”和“长期可预测”不是同一个概念。真正值得花大量时间研究的,是那些我们有可能在很长时间里理解其竞争规则,而且企业本身又确实长期显著优于同行的公司。
如果一家企业能够长期以远高于竞争者的资本回报率经营,同时竞争优势又能够维持,那么这个企业就开始变得非常有意思。这个时候,你的任务就不是每年重新找一个新的故事,而是理解为什么这种优势存在,它靠什么保护,这种优势有没有可能继续。一个优秀企业真正的价值,不只是它今天赚了多少钱,而是它能不能长期把资本以较高的回报率继续投入。只要这一点能够持续,时间就会开始变成你的朋友。
六、安全边际不是保守,而是承认我们永远无法准确预测未来
价值投资里面一个非常重要的概念是安全边际。为什么要有安全边际?因为我们的知识永远有限,而我们投资的又恰恰是未来。无论你研究得多深入,都不可能把未来所有变量算清楚。宏观经济会变化,竞争者会变化,技术会变化,管理层会变化,消费者也会变化。面对这种现实,投资人如果还要求自己做出精确预测,最后往往得到的就是精确的错误。
我早年有些投资,就是因为安全边际足够大,所以即使当时对企业本身理解得还非常有限,也敢于采取行动。有的公司账上实际拥有的资产价值明显高于当时整个公司的市场价值。在这种情况下,我甚至不需要对十年后的盈利能力有非常精确的判断,只要确认这些资产确实存在,企业本身并没有马上要毁掉的重大问题,价格本身就给了我很大保护。后来其中有些投资涨了很多倍,但实际上那并不说明我一开始就准确预测了所有事情,很多时候只是因为买得足够便宜,结果比原本能够合理期待的还要好。
安全边际真正告诉我们的,是要尊重自己的无知。你对未来越没有把握,价格就越需要给你保护;如果价格不能给你保护,你就必须对企业本身有非常高的确定性。当然,这两种确定性并不是完全割裂的。投资人早期可能更容易从资产价格的明显低估中寻找安全边际,随着对企业理解越来越深入,也会逐渐认识到,一个极其优秀、长期能够高回报再投资的企业,本身也可以创造另外一种安全边际,因为时间和企业的复利能力会不断替所有者工作。
但是无论哪一种情况,核心原则都一样:你必须为错误留出空间。投资永远不是证明自己聪明,而是在大量不确定中尽量避免永久性资本损失。我们真正应该追求的不是“任何情况下都不会错”,而是“即使某些判断错了,结果仍然能够承受”。这也是价值投资为什么可以长期生存的一个根本原因。
七、企业的护城河不能只看一个标签,真正重要的是竞争优势为什么可以持续
很多人研究企业的时候,很喜欢问一个标准化的问题:护城河到底是什么?是品牌,是管理层,是商业模式,是网络效应,还是成本优势?我越来越觉得,这个问题不能离开具体企业来抽象回答。每个行业的竞争优势来源都不同,而且不同时间尺度下,决定企业表现的因素也不一样。
如果你的时间尺度比较短,人当然非常重要。一家企业在创业早期、行业高速发展期,创始人和核心管理团队可能对企业价值产生极大的影响。优秀的企业家可以做出连续正确的决策,也可以吸引优秀人才,在不确定环境里不断改变组织。但是时间尺度越长,行业本身的结构往往越重要。一个再优秀的人,如果长期处在极差的商业环境、极差的行业结构里,也很难产生长期非常优秀的经济结果;反过来,有些企业即使管理者未必极其特殊,因为行业本身的条件很好,也可以获得相当不错的回报。
所以我不太愿意把护城河简单归纳为几个词。真正应该研究的是,为什么这家企业在竞争中能够长期获得高于同行的经济回报,而这个原因为什么没有被竞争者复制和消灭。品牌只有在能够转化为定价能力、客户忠诚或者更低获客成本的时候才有经济意义;规模只有在能够带来成本优势或者网络优势的时候才有价值;优秀管理层只有在他的能力可以真正转化为企业长期竞争优势时才重要。最后所有这些分析都必须落到一个非常具体的问题上:这种超额回报能够维持多久?
这也是为什么研究企业不能只研究财务报表。你必须了解管理层,也必须了解行业基本规则,还要了解竞争者、客户、供应商、资本需求、技术变化以及整个产业链上的经济关系。真正建立一个企业的能力圈,需要的信息非常多,而且最后你仍然可能得出一个结论:这个企业就是无法判断。接受这个结论很重要。投资里面一个非常大的进步,往往不是你增加了多少“可以买”的公司,而是你能够更加快速、更加有信心地把大量公司排除在自己的范围之外。
八、一个真正适合做价值投资的人,需要一种非常特殊的“品性”
巴菲特和芒格经常讲,投资成功最重要的并不是智商,而是 temperament。我一直觉得这个词中文很难完全准确地翻译,我自己更愿意叫它“品性”。这里面既有一些天生的性格,也有大量后天可以训练的东西。为什么投资需要这种特殊的品性?因为投资的工作环境和人的天性其实存在很大的冲突。
第一是独立性。你需要能够接受别人长时间不同意你。市场可能和你不同意,媒体不同意你,同事不同意你,客户甚至也不同意你。如果你的心理稳定必须建立在别人认同上,那么在市场里会非常困难。但这里再次要强调,独立不等于固执。独立是你最后服从事实和逻辑,而不是服从社会压力。如果事实改变了,你应该立刻改变;如果只是价格和情绪改变,而事实没有改变,你就不应该轻易被带走。
第二是耐心,而且是一种常人很难适应的耐心。真正好的机会很少。有些优秀投资人可以连续看一个领域几十年,在三十多年里面可能才真正遇到一次值得重仓行动的机会,之后又很多年没有第二次。但是他仍然会继续看、继续研究。机会不来的时候,完全可以什么都不做。这种状态对很多人其实非常难,因为金融行业的文化通常在奖励行动,每天都有人告诉你必须做点什么,必须产生交易,必须有观点。但真正的投资并不按照这种节奏发生。
第三是机会真正出现以后敢于行动。很多人能够长期观察,也能够讲出很多正确道理,但到了真正便宜、市场极度恐慌的时候,却没有办法把研究转化为行动。优秀投资人的品性非常特殊:在绝大部分时间里可以极其克制,在真正的机会出现时又可以突然变得非常果断。这两种特性看上去甚至有些矛盾,但投资真正需要的恰恰就是这种组合。你不能因为“长期主义”而永远不行动,也不能因为“果断”而每天交易。
第四是对商业有一种近乎本能的兴趣。有人把它叫 money sense,我觉得更准确地讲,就是你看到一个生意以后会自然地想知道,它到底怎么赚钱,为什么赚这个钱,为什么客户愿意买,为什么竞争对手没有把利润抢走。有这种兴趣的人不需要别人每天督促他研究,因为研究本身对他就有吸引力。没有这种兴趣,仅仅因为觉得投资行业收入比较高而进入,通常很难坚持几十年。你会发现,真正优秀的方向往往是兴趣和能力能够互相强化的地方。
九、知识上的诚实,比聪明更加稀缺
这些年我观察过很多很聪明的人,也见过很多人在投资上最后并不成功。聪明当然不是坏事,但聪明有一个很大的危险,就是一个人越聪明,越有能力为自己的错误制造出非常复杂的解释。真正难得的是知识上的诚实,也就是 intellectual honesty。
什么叫知识上的诚实?就是你愿不愿意不断问自己:我到底知道什么?我不知道什么?这个结论到底来自事实,还是来自我希望它是真的?如果明天出现什么事实,我会承认自己原来的判断错了?如果我无法回答这些问题,我其实还没有真正拥有这个观点。真正的研究不是证明自己对,而是尽可能快地发现自己可能错在哪里。
人在天生的心理结构上并不是为客观理性设计的。我们的大脑首先是自然选择的结果,它最重要的功能是帮助我们生存,而不是帮助我们在现代资本市场里做完全理性的概率判断。所以我们带着大量天然的心理倾向进入现代社会,会产生很多结构性的盲点。确认偏误、从众心理、损失厌恶、权威影响、自我服务偏误,这些东西并不会因为一个人学历高就自动消失。有时候,知识更多反而会让这些偏误变得更精巧,因为你拥有了更复杂的语言来合理化它们。
这就是为什么价值投资最终是一种持续的自我训练。你不仅是在研究企业,还要不断观察自己做判断的方式。为什么我突然喜欢上这个公司?是不是因为股价最近涨了?为什么我突然认为原来的风险没那么大?是不是因为我已经买进去了?为什么我对一个反方意见特别反感?是不是因为它触碰到了我已经投入很多时间和金钱的观点?这些问题如果长期认真问,慢慢会变成一种习惯。这个习惯不仅对投资有用,对一个人的一生都很重要。
十、学习没有神奇捷径,真正可靠的方法仍然是兴趣、科学方法和长期积累
有人会问,怎样学习才能形成所谓知识的复利?我自己的体会其实并没有什么特别神秘的方法。一个真正有用的知识,首先应该能够在相当程度上被事实和逻辑支持;其次,它应该具有比较强的解释力,能够帮助我们理解一些现实问题;最后,它最好还具备某种预测能力。按照这个标准,人类到目前为止最可靠的一类知识当然是科学知识。
但是投资有一个特殊问题:我们研究的大多数事情都和人有关。只要和人有关,结果通常就不会像物理实验一样给你一个高度确定的答案,而更多表现为一个概率分布。所以我一直觉得,统计思维在现实世界里非常重要。我们当然仍然应该使用科学方法,但是必须接受,最后很多时候只能得到一个“模糊的正确”,而不是一个“精确的答案”。投资里面最危险的一种幻觉,就是用大量数字制造出一种虚假的确定性。模型可以算到小数点后很多位,并不代表现实真的有那么精确。
所以在学习过程中,宁可接受模糊的正确,也不要沉迷于精确的错误。你应该不断寻找有解释力、有预测能力、能够被现实反复检验的知识,并且把这些知识慢慢连接起来。最开始的时候这种积累看不出太大效果,但是时间长了以后,不同学科、不同企业、不同时期得到的经验会开始互相印证,这时知识就真正产生复利。
另外一个非常重要的东西就是兴趣。一个人如果真正对一个问题有兴趣,他会在别人停止的时候继续往下想,在别人已经接受一个答案的时候再问一个“为什么”。这种差别一天两天看不出来,十年、二十年以后就会非常大。最容易形成长期竞争优势的地方,通常不是你被迫学习得最多的领域,而是你有兴趣到停不下来的领域。因为别人工作结束了,你仍然觉得这件事本身有意思,于是你自然积累得更深。
所以如果一定要让我总结学习方法,我还是会说:让兴趣引导你,用科学的方法检验你得到的认识,然后用知识上的诚实不断修正错误,一点一点积累。这个过程很慢,也没有任何捷径,但是到目前为止,这是我看到唯一真正可靠的方法。
十一、不要试图寻找一种统一的“优秀企业家人格”
投资人经常会问,我最看重企业家的什么品质。做商业和投资这么多年,我见过形形色色的企业家,最后反而越来越不愿意用一种标准人格去判断谁一定能够成功。市场经济最有意思的一个地方,就是它允许非常不同的人找到适合自己的位置。一个在普通社会环境里看上去很特别,甚至不太容易相处的人,在某一个商业环境里可能恰恰能够把自己的特殊能力发挥到极致。
所以我不会先建立一个所谓“伟大企业家的标准画像”,然后去市场里找符合这个画像的人。真正应该做的是从企业本身出发,研究为什么这个人能够建立出这样的组织,他的特点在这个组织里到底发挥了什么作用,他的缺点是不是被其他人或者制度弥补了。有的企业家并不喜欢管细节,却特别擅长找到优秀的人;有的人组织能力一般,但是对产品有极端敏锐的感觉;有人对成本极其敏感,有人擅长长期资本配置。不同企业所需要的能力组合完全不同。
这也是为什么企业分析必须具体情况具体分析。你不能因为一个企业家看上去符合某种传统意义上的“优秀人格”,就认为企业一定优秀;也不能因为一个人看上去不符合普通人的成功模板,就过早否定他。市场经济本身就是一个非常强大的筛选机制,它会让很多异质的人在不同领域寻找自己的 niche。作为投资人,我们真正要判断的,仍然是这种人与组织的组合能不能长期创造经济价值。
十二、普通投资者真正需要避免的,首先是被市场诱惑
并不是所有人都应该成为职业投资人。事实上,真正建立能力圈、长期研究企业,是一个需要大量时间和兴趣的工作。如果一个普通投资者不愿意花这么多时间,那么完全没有必要勉强自己做专业投资人的工作。对大多数人来说,更重要的可能是用一种可靠的方法保护并长期增加自己的财富。
如果一个经济体已经进入了可以持续累进增长的现代经济阶段,而且一个指数能够比较充分地代表这个经济体中主要企业的长期表现,那么长期指数投资本身就是一个很合理的选择。因为从整体上看,投机者的净结果最终彼此抵消,而指数长期获取的主要就是企业总体经济增长的结果。当然,这个结论有前提,就是经济体本身能够长期创造增长,而且指数具有足够代表性。
另外一种选择,是把资金交给真正优秀的投资人。但是选择优秀投资人本身并不容易。首先要判断他到底是投资者还是投机者;其次要看他有没有真正适合投资的品性;第三要看他是否在自己专业领域形成了深度,而且这种能力有没有经过足够长时间的实际业绩检验;还要看他的能力圈是否真实,以及他的激励机制是不是和投资人一致。真正长期而可验证的 track record 很重要,因为一个人讲一套非常漂亮的投资理论很容易,几十年把一套方法持续做出来要难得多。
普通投资者最应该避免的事情,往往是市场越热越想进去,市场越冷越想出来。人的天性在这方面几乎天然和正确的投资行为相反。价格上涨以后,我们觉得安全;价格暴跌以后,我们觉得危险。但如果企业本身的价值没有以同样的幅度变化,这种感觉恰恰可能把一个人带到最坏的交易位置。所以无论是指数投资,还是把钱交给真正可靠的专业投资人,最重要的一件事都是不要反复被市场情绪牵着走。
十三、价值投资不能脱离时代,但也不能退化成宏观预测
到了最近这些年,我对价值投资和时代之间的关系思考得越来越多。价值投资从方法上讲当然是自下而上的,我们从企业基本面开始。但是企业从来不生活在真空里。它必然存在于一个具体国家、一个具体制度、一个具体时代和具体的国际环境中,资本、技术、市场、贸易关系、社会治理和消费者信心的变化,最后都会以不同方式影响企业。
因此,当时代发生非常大的结构变化时,价值投资人不可能完全装作没有看到。过去几年,无论是中国内部的经济调整,还是全球政治经济环境,都出现了很多让人困惑的变化。就业、企业家信心、房地产、资本市场、消费、需求,以及主要国家之间的关系变化,都会让人自然地产生一个问题:我们过去理解的那些长期规律是不是还有效?企业未来还能够像过去一样创造价值吗?
要回答这些问题,我觉得必须把时间尺度再放长一些。过去几百年真正改变人类社会的一个根本现象,是现代科技和市场经济结合以后,经济开始出现持续的、累进的增长。在农业文明时代,一个社会最核心的经济资源是土地和人口,因为财富生产有非常明确的物理上限。在这样的世界里,一个群体获得更多财富,往往意味着另外一个群体失去土地和资源,所以长期的国际关系天然带有非常强烈的零和性质。
但是进入现代科技文明以后,情况发生了变化。经济增长越来越依赖知识、技术、资本、商品和服务之间的充分交换。商品与商品之间的交易可能形成一加一大于二,知识和思想之间的交流有时候甚至可能产生更大的增量。这个时候,一个社会真正重要的经济边界不再只是土地有多大,而是市场有多大,资本能不能流动,技术能不能交流,生产要素能不能以相对有效的方式配置。
从这个角度看,所谓现代化,不仅仅是造出了多少工厂或者拥有多少基础设施,而是整个经济系统是不是进入了一种可以持续产生福利增长的状态。如果技术进步和市场机制能够不断产生新的生产力,一个企业就有机会长期扩大价值,这也是价值投资能够长期成立的宏观基础。
十四、中国今天的困难,需要放到“工业起飞之后的转型”中理解
中国在过去四十多年经历了非常快速的经济变化。这种变化当然是历史性的,但是如果放到近代世界史里面看,一个后发国家完成最初工业化追赶时,三四十年的高速变化并不是完全没有先例。德国、日本、美国以及很多其他经济体,在不同历史时期都经历过非常快速的工业起飞。真正困难的地方往往出现在最初起飞完成以后,因为经济结构已经发生巨大变化,但社会治理、人的观念、制度安排和社会心理不会以同样的速度自动调整。
这个时候就会出现一个结构性落差。经济已经进入新的阶段,人们仍然可能沿用过去形成的很多观念;生产能力已经很强,但是需求结构、资本配置、社会保障、居民消费、企业信心未必同步完成转型;社会创造了大量储蓄,但这些储蓄是否能够真正有效转化为长期生产资本,又取决于金融体系和资本市场的成熟程度。很多所谓的“中等收入阶段问题”,其实都和这种转型有关。
所以对于今天中国遇到的困难,我认为既不能轻视,也没有必要把它理解为历史上完全不存在、无法理解的问题。一个价值投资人要尽可能把时间尺度拉长,既看到现实中的具体约束,也看到更长期的结构性力量。短期极度悲观和短期极度乐观,本质上都是一种容易被当下情绪绑架的状态。真正重要的是分析哪些问题是周期性的,哪些是结构性的,哪些制度安排正在发生变化,以及这些变化最后会怎样传导到具体企业。
这也是为什么宏观环境虽然重要,价值投资仍然必须回到企业。你很难准确预测十年以后所有国际关系,也很难预测每一项政策的精确路径。你真正能够做的是寻找那些在相当广泛的情形下仍然可以生存、适应和创造价值的企业,并且对那些自己无法预测的部分留出足够安全边际。如果一个投资最后完全建立在你精确预测某一次宏观事件之上,那实际上你已经把自己的成功建立在一个非常脆弱的条件上。
十五、现代资本市场真正提供的不只是钱,而是一套信用体系
我们今天谈资本市场,经常把它简单理解成融资工具,好像资本市场最大的功能只是给企业提供钱。但银行也可以提供钱,所以如果资本市场只有融资这一个功能,它的重要性就很难真正解释。现代资本市场更深层的功能,是建立一套能够把社会储蓄持续转化为生产资本的信用体系。
在这套体系里,企业家要有企业家的信用,投资人要有投资人的信用,连接储蓄者和投资者之间的各种中介机构也要有自己的信誉。一个普通储蓄者可能完全不懂某一家具体企业,但他可以通过一系列可信的制度安排,把自己很小的一部分储蓄投入到一个自己从未见过的企业里。无数小额储蓄汇集以后,形成巨大的资本力量,然后投入真正能够创造生产力的企业,企业创造利润以后,这些利润又重新回到资本所有者手里。整个过程之所以能够运转,关键不只是钱,而是信用。
这也是为什么我认为市场经济和价值投资之间存在非常深的关系。价值投资不是一个人在赌场里想办法从另外一个人手中拿走更多筹码,而是在一个有效市场经济体系里,把资本配置给真正能够创造价值的企业。如果你的判断是正确的,企业家得到了资本,企业发展了,员工和客户获得了价值,投资人也获得了回报,这本质上可以是一种多赢。
从这个意义上讲,投资人的信用本身就是一种非常重要的资产。一个投资机构如果不断改变自己的规则,只追逐短期流行的产品,最后连自己的真实长期业绩都说不清,那么投资人很难真正判断他到底创造了什么。长期资本真正需要的,是可验证的历史,是一致的行为,是在不同市场环境下仍然能够看出一个人到底按照什么原则行动。信用和知识一样,需要几十年积累,却可以在很短时间里毁掉。
十六、全球价值投资真正要解决的,是如何在变化的时代中寻找不变的经济规律
今天做全球价值投资,当然比过去面对更多复杂因素。不同国家之间的关系、贸易体系、技术管制、资本流动、产业链重构,都会影响企业价值。因此所谓“全球价值投资”,绝不意味着看到任何国家的便宜股票就可以买。你必须把政治、制度和社会环境看成企业基本面的组成部分,而不是一个完全独立的宏观话题。
但这并不意味着投资人应该把自己变成国际政治预测家。恰恰相反,价值投资真正重要的地方,是明确哪些事情无法预测。世界永远会出现意外,国际秩序也会不断变化。一个价值投资人的任务不是准确预测每一场风暴,而是尽量拥有那些能够穿越相当多风暴的资产,同时确保买入价格给自己留下足够空间。
所以做全球投资的时候,我仍然会回到那些最基本的问题:这个企业创造的产品或者服务是否真正有价值?它在竞争中的位置是什么?资本回报如何?这种回报来自什么?企业文化和治理是否可靠?所在国家的制度是否能够保护财产权和正常商业活动?资本是否能够正常进出?企业是否过度依赖某一种自己无法判断的政治条件?只有把这些问题一层一层弄清楚,所谓时代分析才真正落到了价值投资上。
十七、投资最终是一场不断“熵减”的求知过程
做投资这么多年以后,我越来越觉得,投资真正吸引我的,并不只是资本回报本身。世界上赚钱的方法很多,真正让我觉得这件事值得做一辈子的原因,是它迫使一个人不断追求真知。
现实的物理世界很多过程是熵增的,但是人有一个非常特殊的地方,就是我们可以通过学习不断增加有序的知识。一个人可以从完全无知开始,通过学习逐渐理解越来越多的规律;可以通过修养不断改变自己的品性;可以因为理解了一个新的科学原理而创造过去完全不存在的产品;也可以因为看懂了一家企业真正创造价值的方式,把资本配置给它,从而帮助一种新的生产力成长。
回过头来看,过去几十年里很多改变世界的东西,最初不过是少数人掌握的一点“小小的真知”。计算机、互联网、通信技术,最底层看起来都不过是一些非常基础的科学和工程原理,但是这些知识被不断组合以后,可以让整个世界发生不可想象的变化。投资人如果能够真正理解这些创造价值的过程,然后把资本配置到正确的方向,他得到的不只是自己的财富增长,也参与了社会生产力增加的过程。
所以我越来越觉得,价值投资真正的“正道”,本质上也是一种熵减的旅程。你不断减少自己的无知,不断修正自己的偏见,不断建立更加可靠的知识,同时把自己积累的资本配置给真正能够创造价值的人和企业。这个过程如果做对了,它可以是多赢的:企业获得资本,社会获得产品和服务,投资者获得长期回报,而你自己也因为这个过程变成一个比过去更加理性、更加诚实、知识更加丰富的人。
十八、真正属于一个投资人的机会,一生不会太多
投资时间越长,我越相信真正属于一个人的机会其实非常有限。金融市场每天都有无数价格变化,每一年都有新的热门行业、新的技术、新的叙事,但是大部分东西与你没有关系。你不需要抓住全部机会,也根本不可能抓住全部机会。
真正重要的是,你有没有逐渐形成一个真实的能力圈,并且在这个圈里保持长期观察。当机会没有出现的时候,你就读书、研究、思考,可以什么都不做;当一个企业真正进入你的能力圈,而且价格又给了足够安全边际的时候,你必须有能力识别它;而当这种极少数机会真正出现时,你又必须有足够的定力采取行动。
所以价值投资最后形成了一种非常不同的生活节奏。大部分时间很平淡,没有那么多戏剧性的变化。你每天做的事情是阅读,是观察,是和人交流,是修改自己的思维模型。也许很多年都没有一笔真正改变结果的投资。但是复利的特点本来就是这样:真正重要的结果常常来自少数几件事情,然后在很长时间里持续积累。
从这个意义上说,一个投资人不应该害怕无聊。很多时候,无聊本身就是正确状态。真正危险的反而是你每天都觉得必须做点事情,必须有一个新观点,必须证明自己一直在工作。市场不会因为你很勤奋地交易就奖励你,市场最终奖励的是正确判断和正确价格。
十九、知行合一,最终还是回到认识自己
价值投资讲到最后,其实越来越像一个关于人的问题。为什么同样的道理,有些人可以坚持,有些人不能?为什么同样研究一家公司,有些人可以在价格下跌时保持客观,有些人会陷入恐慌?为什么有人可以等待十年,有人十天不交易就很难受?这些区别最后都和一个人的兴趣、性格、知识结构、心理习惯以及价值观有关。
所以不是每一个人都一定适合做专业价值投资。一个人真正最容易成功的方向,往往是兴趣和能力能够结合的方向。如果你的兴趣根本不在商业和投资,完全没有必要因为听说某个行业挣钱多就强迫自己进入。这个世界永远有人赚得比你多,如果人生方向只由别人赚多少钱来决定,你会不停地改变自己,最后什么事情都很难做深。
如果一个人确实对商业有兴趣,也具备比较强的独立性,能够长期学习,愿意承认错误,能够忍受等待,而且在真正有把握的时候能够行动,那么价值投资可能是一个非常适合他的方向。但即使如此,这仍然是一个几十年的学习过程。能力圈不是一天建立起来的,品性也不是听完一场课就获得的。很多东西必须通过真实的投资、真实的错误、真实的市场波动,一点一点训练出来。
我自己到今天也仍然在这个过程中。做了这么多年投资,并不意味着我对所有问题都有答案,反而会越来越清楚自己的知识有多么有限。但也正因为如此,我越来越喜欢这件事情。因为每过几年回头看,你会发现自己真正学会了一些过去完全不知道的东西,过去一些模糊的认识慢慢变得清楚,一些曾经非常自信的判断又被证明其实并没有那么可靠。这种不断修正、不断积累的过程,本身就是投资最大的价值之一。
二十、结语:把时间留给真正值得复利的东西
如果让我今天重新总结价值投资,我仍然不会增加很多新的原则。股票代表企业所有权,市场为你服务而不是指导你,未来只能用概率来理解,因此必须保留安全边际;同时,一个人要用长期学习建立能力圈,并且只在真正理解的范围之内投资。这些原则过去有效,我相信以后也仍然会有意义。
真正改变的,是随着经验增加,你会越来越理解这些简单原则背后的分量。你会明白“股票是所有权”并不是一句定义,而是一种心理位置的改变;“市场先生”不是一句幽默的比喻,而是一个人能否保持独立性的考验;“安全边际”不是保守,而是承认人类知识有边界;“能力圈”不是炫耀你懂多少,而是清楚知道自己不知道什么;“品性”也不是一个漂亮的道德词汇,而是在几十年市场波动里,你到底能不能按照事实和逻辑生活。
时代当然会变化,而且有些时候变化得非常剧烈。但是从一个价值投资人的角度看,我们最需要做的,不是每天预测所有变化,而是不断寻找那些在变化之中仍然成立的经济规律。技术可以变化,行业可以变化,国际环境也可以变化,但长期创造价值、有效配置资本、保护财产权、建立信用、鼓励知识和生产要素充分交换,这些因素仍然决定着一个经济体和企业能不能持续发展。
最后,一个人真正能够形成复利的东西其实并不多。知识可以复利,信用可以复利,好的品性可以复利,优秀企业的资本回报也可以复利。真正值得做的事情,是把时间和精力放到这些能够长期积累的东西上,而不是每天被短期价格和情绪带走。
对我来说,价值投资最终已经不仅是一套投资方法。它更像是一种认识世界的方法,也是一种认识自己的方法。它要求你尊重事实,尊重概率,尊重常识,也尊重自己的无知;它要求你长期学习,又要求你接受大部分时间什么都不用做;它要求你有自己的判断,同时又随时准备在新事实出现时承认自己错了。
如果一个人能够把这些事情真正做一辈子,我想,即使最后没有成为一个职业投资人,他得到的也不会只是怎样买股票。因为追求真知本身可以改变生活,长期积累本身可以改变命运,而一个越来越理性、越来越诚实、越来越了解自己边界的人,无论最终从事什么职业,大概率都会拥有一个更加完整的人生。
- ZZethes Post #132
书名:《家庭论》(A Treatise on the Family)
作者:加里·S·贝克尔(Gary S. Becker)
诺贝尔经济学奖得主
简介
这本书具体回答了以下关于家庭行为的硬核经济学问题。它不满足于描述现象,而是试图解释这些现象背后的因果机制和均衡结果:
1. 婚姻市场与配偶选择:谁和谁结婚?为什么会有彩礼/嫁妆?
- 正向匹配 vs. 负向匹配: 为什么高学历的人倾向于找高学历的伴侣(正向匹配),而传统家庭中往往是“男主外、女主内”(负向匹配/互补匹配)?
- 回答: 这取决于特质是“互补”还是“替代”。如果双方都在市场工作能产生规模经济或协同效应,则正向匹配;如果一方在市场工作效率高,另一方在家务生产效率高,则负向匹配能最大化家庭总产出。
- 彩礼与嫁妆的经济本质: 为什么有些文化流行彩礼(男方给女方),有些流行嫁妆(女方给男方)?
- 回答: 贝克尔将婚姻视为一个市场,彩礼/嫁妆是 “婚姻价格”(Marital Price),用于平衡供求。
- 如果男性在婚姻市场中相对稀缺(或女性竞争激烈),女性家庭需支付嫁妆以吸引优质男性。
- 如果女性在婚姻市场中相对稀缺(或男性竞争激烈),男性家庭需支付彩礼以争取女性。
- 这也解释了性别比例失衡对婚姻支付的影响。
- 回答: 贝克尔将婚姻视为一个市场,彩礼/嫁妆是 “婚姻价格”(Marital Price),用于平衡供求。
- 离婚率上升的原因: 是因为现代人更冷漠了吗?
- 回答: 不完全是。主要原因是搜索成本降低(约会 APP、社交网络)、法律交易成本降低(无过错离婚法的普及)以及女性经济独立性增强(提高了离婚的外部选择价值)。
2. 家庭内部分工:为什么通常是“男主外、女主内”?
- 微小差异的放大效应: 为什么男女在生理上的微小差异(如生育哺乳)会导致巨大的职业隔离和工资差距?
- 回答: 基于比较优势和人力资本专用性。一旦女性因生育稍微减少市场工作时间,她在家务上的相对效率就略高于男性。为了最大化家庭总产出,理性选择是让女性进一步专业化于家务,男性专业化于市场工作。这种专业化导致女性在市场人力资本积累上落后,从而拉大工资差距,反过来又强化了分工——这是一个自我强化的循环。
- 时间分配: 为什么富人雇佣保姆,而穷人往往自己照顾孩子?
- 回答: 取决于时间的机会成本。高收入者的时间影子价格极高,因此购买市场服务(保姆)比亲自做家务更划算;低收入者时间成本低,亲自生产更经济。
3. 生育决策:为什么越富有的国家生得越少?
- 数量 - 质量权衡(Quantity-Quality Trade-off): 为什么收入增加没有导致人口爆炸,反而导致生育率下降?
- 回答: 父母面临预算约束:。
- 随着收入增加,父母不仅想要更多孩子,更想要高质量(高教育、健康)的孩子。
- 提高每个孩子质量的边际成本很高(学费、精力),因此父母选择少生优生。收入效应被质量需求的收入弹性所抵消甚至逆转。
- 回答: 父母面临预算约束:。
- 女性工资与生育率的负相关: 为什么女性受教育程度和工资越高,生育率越低?
- 回答: 机会成本效应。孩子的“价格”不仅是奶粉钱,更是母亲放弃的市场工资。女性工资越高,生孩子的机会成本越高,因此生育需求下降。
- 避孕技术的影响: 避孕药如何改变女性命运?
- 回答: 降低了意外怀孕的风险,使女性能更精准地规划人力资本投资(如读完博士再生育),从而推迟初育年龄并减少终身生育数量。
4. 利他主义与代际转移:父母真的无私吗?孩子会啃老吗?
- 罗腾伯格定理(Rotten Kid Theorem): 如果一个孩子是自私的(只关心自己消费),而父母是利他的(关心孩子福利),家庭内部还能实现资源最优配置吗?
- 回答: 能。 只要父母拥有足够的财富并通过转移支付(零花钱、遗产)来调节,自私的孩子为了最大化从父母那里得到的转移支付,会自发采取增加家庭总收入的行为。即:利他的家长可以“操控”自私的孩子做出符合家庭整体利益的选择。
- 遗产动机: 人为什么要留遗产?
- 回答: 并非仅仅因为死后钱没用。遗产是跨期资源配置的工具。如果是利他主义动机,遗产是为了平滑子女一生的消费;如果是战略动机,遗产是为了换取子女生前的照料(“你照顾我,我多给你留点”)。
- 教育投资的不足: 为什么父母有时不愿借钱给孩子上学?
- 回答: 承诺问题(Commitment Problem)。 孩子无法承诺未来赚了钱一定偿还父母。由于缺乏强制执行的契约,父母可能担心投资打水漂,导致对孩子的人力资本投资低于社会最优水平。这也为政府提供公共教育提供了理论依据。
5. 扩展家庭与社会网络:亲戚有什么用?
- 亲属网络的保险功能: 在没有现代保险和金融市场的传统社会,大家庭如何生存?
- 回答: 亲属网络充当了非正式的保险公司。通过互惠的礼物交换、借贷和照料,家族成员共同分担疾病、失业或歉收的风险。
- 社会资本的形成: 为什么某些社区犯罪率低、合作度高?
- 回答: 紧密的社会网络降低了监督和执行规范的成本。如果一个人背叛社区,他将失去整个网络的支持(社会制裁),这种高昂的违约成本促进了合作。
总结
贝克尔并没有说“爱情不存在”或“亲情是买卖”,他回答的是:在资源稀缺、信息不完全、制度约束存在的现实世界中,情感驱动的行为如何契合理性达到某种均衡。
- 正向匹配 vs. 负向匹配: 为什么高学历的人倾向于找高学历的伴侣(正向匹配),而传统家庭中往往是“男主外、女主内”(负向匹配/互补匹配)?
- ZZethes Post #269
2026 年 7 月 15 日 CNBC《Squawk Pod》沃伦·巴菲特特别专访的要点总结及关键原文对照。
1. 慈善捐赠策略重大调整:停止资助盖茨基金会
巴菲特宣布不再向比尔及梅琳达·盖茨基金会捐款,转而大幅增加对其亡妻苏珊·汤普森·巴菲特基金会(STB)及三个子女基金会的资助。他强调这并非因个人恩怨或对盖茨的不信任,而是基于对子女能力的认可及自身年龄的紧迫感。
- 关键点:
- 已读阅爱泼斯坦相关档案及国会证词,认为盖茨虽犯错但并未超出常人范畴,友情依旧。
- 已向盖茨基金会捐赠约 470 亿美元,认为其已有足够资源。
- STB 基金会今年获捐额度增至去年的 10 倍(约 45 亿美元),填补了原盖茨基金会的份额。
- 子女基金会运营高效,费用率接近 1%,无官僚主义。
关键原文:
- “自 1 月 1 日以来,我阅读了大量关于比尔和爱泼斯坦之间发生的事情的资料……我在那些资料里没有发现任何超出我能想象的、甚至我能想象自己也可能会做出的事情。”
- “我已经给了盖茨基金会非常大的一笔钱,总共大概有 470 亿美元……当时我并不觉得我的孩子们做好了管理如此巨额财富并进行捐赠的准备……我认为出现这种情况(子女准备好)的概率极其高。”
- “STB 基金会完全是我的第一任妻子会创建、且我会全力赞同的机构……他们拿到了原本属于苏珊·汤普森·巴菲特基金会该拿的部分,还要再多一些。”
2. 财富分发加速与继承计划
巴菲特将慈善股份全部分发完毕的时间表从“去世后 10 年”提前至“未来 8 年内(2034 年底前)”。这一改变主要源于对自身及子女年龄的现实考量,以及对继任者格雷格·阿贝尔(Greg Abel)的绝对信任,使得家族长期控制投票权变得不再必要。
- 关键点:
- 目标在 2034 年底前完成所有股份捐赠。
- 对格雷格·阿贝尔的信任度为 100%,无需家族通过持股来监督公司。
- 承认衰老风险,希望在头脑清醒时完成安排。
- 遗嘱规定子女决策需一致同意,若无法执行则成立新基金会。
关键原文:
- “现在您却说,您希望在自现在起 8 年内(也就是到 2034 年底)将所有股份发放完毕……这不仅是一个生命长短的问题,也是一个我们到时还能不能保持清醒头脑的问题。”
- “我对接班人的标准定得极高……显然,我们已经找到了这个人,就是格雷格·阿贝尔(Greg Abel)。这一点每天都变得更加清晰。”
- “我之所以一直留在董事会里,很大程度上也是因为我们过去没有对某个人产生过如此充分的信任……我对格雷格也有这种百分之百的信心。”
3. 投资逻辑进化:重仓 Alphabet 与坚守 Apple
巴菲特打破了以往不碰科技股的刻板印象,揭示了伯克希尔当前的科技投资逻辑:看重资本回报率而非单纯的“性感”概念,并确认了对苹果和谷歌的长期信心。
- 关键点:
- Alphabet (Google): 持仓已超 300 亿美元(含私募),位列前三。由巴菲特亲自发起,看重其在 AI 巨额资本支出下仍能维持远高于国债的回报率。
- Apple: 依然是最大重仓股。将蒂姆·库克比作“斯特拉迪瓦里名琴”,无可替代。尽管面临竞争和诉讼,仍视其为极佳的消费品/科技公司。
- 科技观转变: 承认 AI 时代需要巨额资本支出(Capex),只要回报率高且可预测,即符合价值投资标准。
关键原文:
- “(Alphabet)是我发起的……它在我们的持仓里大概排在第五或第六……如果把与之配套的 100 亿美元私募算进去,它的持仓总额应该超过了 310 亿美元。”
- “一家好的公司,其回报率必须远高于国债这种无风险资产……根据过往的记录,我认为他们成为赢家的概率,要远高于华尔街上推销的 90% 到 95% 的东西。”
- “没有任何人能替代蒂姆在我心目中的位置。如果你已经拥有了一把斯特拉迪瓦里(Stradivarius)名琴在为你演奏,就不要再花个 300 年去寻找另一把了。”
4. 宏观视角:美联储、市场投机与可口可乐诉讼
巴菲特对新任美联储主席表示支持,批评了市场上的赌博心态和政府利用彩票筹款的犬儒主义,同时关注可口可乐的税务诉讼风险。
- 关键点:
- 美联储: 赞赏新任主席 Kevin Warsh 的人品与尽责,认为利率仍是股市“地心引力”。
- 市场情绪: 当前市场投机氛围浓厚,“培养赌徒”比“培养投资者”更赚钱;真正的机会稀缺。
- 可口可乐: 面临 IRS 200 亿美元追税诉讼,虽不会导致破产,但影响重大,等待法院裁决。
- 人生哲学: 强调“出生彩票”理论,认为自己极其幸运,慈善是为了修剪不平等的边缘。
关键原文:
- “我认为他是一个极佳的人选……公众能感受到他是真心关切这个国家的利益。”
- “由于人类天生热爱赌博,因此在‘培养赌徒’上能赚到的钱,远比在‘培养投资者’上多得多……有时候机会像雨点一样向你砸过来……而有时候,你可能好几年都碰不到一个值得投资的项目。”
- “即使补缴这笔税款也不会让可口可乐破产……我习惯先考虑最坏的情况(Downside),只要坏情况在可控范围内,好情况(Upside)自然会水到渠成。”
- “我出生时就赢得了这世上最大的‘出身彩票’……我无法改变这个世界的设计,但我可以通过慈善来稍微修剪一下不平等的边缘。”
- 关键点:
- ZZethes Post #2
综合沃什(Kevin Warsh)在这篇杰克逊霍尔研讨会上的完整演讲核心主旨:美联储必须打破对金融市场的“溺爱”,回归古典央行的纪律性;在确信通胀被彻底击败之前,即使经济展现出惊人的韧性,也绝不会轻易妥协。
1. 核心底线:对 2% 通胀目标的“绝对零容忍”
- 传达的信息:物价稳定不会“自动发生”,通胀也不会“自然回归均值”。2% 是一个不可动摇的硬性固定目标。
- 深层意图:这是在强力锚定长期通胀预期。他明确警告市场,不要幻想美联储会像过去那样容忍 3% 左右的“新常态”通胀。他强调“我们必须确信基础通胀正明确向目标推进,且速度足够快,否则我们仍有工作要做”,这实际上是在打消市场对于 “美联储会为了保经济而提前降息或放松政策” 的侥幸心理。
2. 央行哲学:打破“镜厅效应”,拒绝做华尔街的保姆
- 传达的信息:美联储不应过度关注资产价格,市场也不应过度依赖美联储的指引。他严厉批评了“镜厅问题”(央行看市场脸色制定政策,市场看央行脸色进行交易),并指出这种扭曲最终伤害的是没有金融资产的普通美国人。
- 深层意图:这是在宣告“美联储看跌期权”(Fed Put)的终结。沃什试图重塑央行与市场的边界,警告华尔街:美联储不再是股市和信贷市场的“托底者”。如果维持高利率会导致金融市场波动,美联储将选择承受这种波动,以保护普通人的购买力。
3. 框架改革:废除“前瞻性指引”,回归传统货币政策
- 传达的信息:“前瞻性指引”(提前承诺未来的利率路径)是危机时期的非常规产物,在当前的“正常时期”已经过时且有害。它束缚了美联储的手脚,导致政策僵化。短期利率才是主要工具,应慎用 QE 等非常规手段,并重新关注货币供应量。
- 深层意图:这是他在推动美联储操作框架的“古典化”回归。他主张美联储应该保持“谦逊和低调”,根据最新的真实数据(而非陈旧的预测模型)逐次会议做出决策(Data-dependent),而不是被自己过去说过的话绑架。这意味着未来的市场波动率可能会上升,因为美联储不再提供清晰的“利率路线图”。
4. 宏观背书:经济的“超强韧性”给了美联储“死磕到底”的底气
- 传达的信息:当前经济不仅没有衰退,反而“有所强化”。企业利润飙升、AI 相关资本支出强劲、信贷市场宽松、劳动力市场处于充分就业状态。
- 深层意图:这是在为维持限制性利率(Higher for longer)提供合法性辩护。他的逻辑是:既然实体经济和企业盈利如此强劲,完全没有崩溃的迹象,美联储就没有任何理由因为害怕经济衰退而提前降息。经济的韧性,正是美联储能够安心“熬”到通胀彻底回落的最大资本。
5. 长期与短期的切割:拥抱 AI 革命,但不以此作为当下放松的借口
- 传达的信息:人工智能是堪比工业革命的通用技术,将极大提升供给侧生产力(这在长期是抗通胀的)。但是,这种生产力的提升目前还处于“智力投入”阶段。
- 深层意图:市场上有一种观点认为,AI 带来的生产力爆发将自然压低通胀,因此美联储现在就可以放松政策。沃什明确切断了这种逻辑链条。他承认 AI 的伟大,但明确表示“这不会影响当前的政策决策”。他告诉市场:不要拿长期的 AI 生产力故事,来倒逼美联储当下的货币政策转向。
结论
沃什在这篇演讲中塑造了一个 “务实、鹰派、反尔街依赖” 的央行家形象。
他想传达的最核心的信息是:“好日子(依赖央行放水拯救市场的日子)结束了。”
美联储未来的行事风格将是冷酷、纪律严明且高度聚焦于实体数据的。市场必须学会自己承担风险,而美联储将把所有的火力集中在彻底消灭通胀上,直到任务完成。 - ZZethes Post #2
可以先自我评估,然后用富裕的部分去弥补不足的部分,幸福的关键在于平衡和稳定。
  // --- 1. 数据配置 (8 大维度,24 个问题) ---
    const dimensions = [
        { id: 'health', name: "健康与体能", color: "#ef4444" },
        { id: 'career', name: "事业与工作", color: "#3b82f6" },
        { id: 'finance', name: "财务与金钱", color: "#f59e0b" },
        { id: 'family', name: "家庭与朋友", color: "#10b981" },
        { id: 'romance', name: "爱情与伴侣", color: "#8b5cf6" },
        { id: 'growth', name: "个人成长", color: "#ec4899" },
        { id: 'leisure', name: "娱乐与休闲", color: "#06b6d4" },
        { id: 'environment', name: "物理环境", color: "#84cc16" }
    ];

    const rawQuestions = [
        // 健康与体能
        { dimId: 'health', text: "我对目前的体能、精力和整体身体状况感到满意。" },
        { dimId: 'health', text: "我有能力去维持规律的饮食和睡眠,不会因为极度焦虑而导致躯体化症状。" },
        { dimId: 'health', text: "我有固定的习惯去活动身体,并能在其中感受到身体的活力。" },
        // 事业与工作
        { dimId: 'career', text: "我对目前的工作充满热情,并能从中获得价值感和成就感。" },
        { dimId: 'career', text: "我认为自己目前的工作/事业有清晰的发展前景和成长空间。" },
        { dimId: 'career', text: "我的工作压力在可控范围内,工作外我依然有精力生活。" },
        // 财务与金钱
        { dimId: 'finance', text: "我目前的收入能够满足我的期望,我很少为日常开销发愁。" },
        { dimId: 'finance', text: "我有清晰的储蓄、投资计划,以及应对突发风险的财务储备。" },
        { dimId: 'finance', text: "我对自己的消费习惯感到满意,占固定收入的合理比例,没有失控或沉重的负债。" },
        // 家庭与朋友
        { dimId: 'family', text: "我能感到被家人接纳,而不是被持续的情感勒索。" },
        { dimId: 'family', text: "我有一群可以交心、相互信任、在我脆弱时能托住我的好朋友。" },
        { dimId: 'family', text: "我能够建立健康的心理边界,敢于拒绝和远离持续消耗我的人。" },
        // 情感与伴侣
        { dimId: 'romance', text: "这段伴侣关系(或独处状态)滋养了我的能量,而不是让我感到被极度抽干或患得患失。没有经历单方面的牺牲、打压或创伤联结。" },
        { dimId: 'romance', text: "我和伴侣之间有着良好的沟通,能够建设性地解决分歧与冲突。" },
        { dimId: 'romance', text: "我和伴侣之间可以做到稳定见面(黄金标准:一周一次)" },
        // 个人成长
        { dimId: 'growth', text: "我有精力去接触新技能、新事物,保持对世界的好奇。" },
        { dimId: 'growth', text: "我清楚自己的优缺点,并有意识地在持续进行自我提升。" },
        { dimId: 'growth', text: "我允许自己犯错,能够带着自我悲悯进行内在探索,而不是严厉地评判自己。" },
        // 娱乐与休闲
        { dimId: 'leisure', text: "在工作和责任之外,我有让自己真正感到快乐的兴趣爱好。" },
        { dimId: 'leisure', text: "我没有因为愧疚感而剥夺自己享受平淡生活的权利。" },
        { dimId: 'leisure', text: "我的娱乐休闲活动丰富多样,能够真正帮我恢复精力、让自己彻底放松。" },
        // 物理环境
        { dimId: 'environment', text: "我对我目前居住的房屋(整洁度、舒适度、空间)感到非常满意。" },
        { dimId: 'environment', text: "我觉得目前的居住环境非常安全、便利,能让我感到彻底放松。" },
        { dimId: 'environment', text: "我喜欢我所在的城市或社区,这里的环境氛围让我心情愉悦。" }
    ];
网上的评估一般要注册,可以按这些数据自己 aigc 一份。
- ZZethes Post #266
为什么大型交易所没有“吃掉”小交易所?加密市场碎片化背后的经济学
研究作者:张翼东(Anthony Lee Zhang,芝加哥大学布斯商学院)及其合作者
论文:Competition in the Cryptocurrency Exchange Market
本文为 AIGC传统金融市场有一个非常经典的规律——“流动性孕育流动性”(liquidity begets liquidity)。
一个交易所参与者越多,交易越活跃,买卖就越容易成交;成交越容易,又会吸引更多交易者。按照这个逻辑,市场最终似乎应该越来越集中。
美国股票市场基本符合这一规律:虽然上市股票有数千只,但主要交易场所的数量并不多。
然而,加密货币市场出现了一个看似矛盾的现象:
比特币、以太坊等核心资产高度集中,但交易这些资产的平台却极其分散。全球不仅存在 Binance、Coinbase 等大型平台,还长期存在大量中小型交易所。
为什么大交易所没有凭借流动性优势,把小交易所全部挤出市场?
张翼东及其合作者的研究给出了一个很有意思的答案:
因为加密货币交易市场更像“大宗商品市场”,而不是股票市场。
一、数字货币没有地理边界,交易市场却有
乍看之下,把比特币和玉米放在一起似乎很奇怪。
玉米、石油、黄金都是实体商品,把它们从一个地区运到另一个地区,需要承担运输、仓储和时间成本。
加密货币则完全不同。比特币不存在“中国比特币”和“美国比特币”的区别,同一个链上的资产可以跨国转移,从技术上看几乎没有地理边界。
但张翼东指出,真正决定加密交易所市场结构的,并不只是加密资产本身,而是交易所承担的功能。
中心化交易所实际上连接着两个完全不同的世界:
一端是全球统一的加密资产网络,另一端则是高度本地化的法币、银行和监管体系。
美国用户通常使用美元入金,澳大利亚用户使用澳元,不同国家还有完全不同的银行接口、KYC 规则、牌照制度和监管要求。一家交易所很难低成本地同时覆盖全球所有司法管辖区。
所以,对于交易所而言:
法币体系和监管边界,就相当于传统商品市场中的“运输成本”。
这也是为什么张翼东认为,加密货币交易市场不像纽约证券交易所这样的现代证券市场,反而更类似几百年前由大量地方集市组成的大宗商品市场。
二、小交易所为什么能够长期存在?
答案在于:它们解决的是本地化问题。
一家小型交易所可能没有 Binance 那么深的流动性,但它可能更了解某个国家的监管环境,更容易接入当地银行,也更熟悉当地客户。
于是市场出现了一种分工:
小型交易所负责连接本地客户,大型交易所负责连接整个市场。
这意味着大小交易所并不一定是完全意义上的竞争关系。
小交易所获得当地客户的买卖订单后,会产生局部的供求失衡。
比如某个地区突然有很多人买比特币,那么当地交易所的比特币价格可能暂时高于全球市场;另一个地区如果大量用户卖出,比特币价格又可能偏低。
此时,一个新的参与者出现了:
套利者(arbitrageur)。
套利者从价格低的交易所买入,在价格高的交易所卖出,通过跨交易所转移资产获得价差。
因此,套利者实际上承担了类似传统商品贸易商的角色:他们把不同的“地方市场”连接起来。
三、为什么最后会形成“星形网络”?
张翼东等人的模型发现,一个非常典型的均衡结构是:
星形网络(star network)。
也就是说,市场不会形成“每一家交易所都和所有其他交易所直接交易”的完全网络,而更可能形成:
大量外围小交易所 → 少数中心交易所 → 其他外围交易所
的结构。
现实中的 Binance、Coinbase 等大型交易所,在一定程度上就承担了这样的枢纽功能。
研究发现,外围交易所的价格与中心交易所价格之间的关联,通常明显高于外围交易所相互之间的价格关联;当出现价差时,也往往是小交易所的价格向中心交易所靠拢。
换句话说,大型交易所越来越像一个“价格中心”和“套利清算中心”。
它甚至不需要持有大量净头寸。
理论模型中,中心节点可能从零库存开始,最后仍接近零库存,但由于所有外围交易所都通过它连接,它却承担了极其庞大的交易流量。
这就是一个非常重要的区别:
大型交易所的价值不仅来自“拥有很多客户”,还来自“被其他市场参与者共同选择为连接中心”。
四、为什么套利成本越低,市场反而越容易出现中心?
这里存在一个有趣的权衡。
套利者选择交易场所时主要考虑两个因素:
第一,市场深度。
大型交易所流动性好,买卖规模很大,因此即使套利者交易很多,也不容易把市场价格推走。
第二,价格噪音。
小型交易所流动性比较差,价格波动更大,因此不同小交易所之间反而更容易出现巨大的价差。
于是问题出现了:
到底应该去大型交易所享受深度,还是直接在两个小交易所之间抓取更大的价差?
张翼东的模型发现,这取决于套利运输成本。
如果运输成本很高,套利者每次只能转移少量资产,那么市场深度并不重要——反正交易规模很小,不会明显影响价格。
此时,他们反而更愿意寻找两个价格差异很大的外围交易所。
市场因此比较分散。
但如果运输成本下降,套利者可以进行大规模套利,那么问题就变了。
这时候,大型交易所“市场足够深”的优势会越来越重要。
套利者于是倾向于:
外围交易所 → 中心交易所
而不是:
外围交易所 → 另一个外围交易所。
最终,大量套利者都会选择同一个中心,星形网络就会内生形成。
因此,“流动性孕育流动性”并没有在加密市场消失。
只不过它首先作用的对象不是普通用户,而是套利者。
五、为什么 Binance 上新币,小交易所反而可能受益?
这是这项研究另一个非常反直觉的结论。
按照传统商业竞争逻辑,如果沃尔玛开始卖某一种商品,小店通常会担心自己的客户被抢走。
那么,如果 Binance 上线一种原本只在几个小交易所交易的代币,小交易所是不是应该损失交易量?
研究结果恰恰相反。
当一个币种还没有进入大型中心交易所时,各个小交易所基本相互孤立。
某个交易所即使出现巨大供求失衡,也只能通过本地价格的大幅上涨或下跌来消化。
但是一旦 Binance 或 Coinbase 上线这个币种,一个大型套利中心就出现了。
原本彼此隔绝的交易所 suddenly 被连接起来。
结果是:
价格差异下降,但套利活动和总交易量反而大幅增加。
研究的实证结果显示,中心交易所上线某种资产后,此前小交易所之间明显存在的价差会持续收窄,同时跨交易所套利的频率和规模上升。
也就是说,大型交易所确实可能抢走一部分客户交易量,但是它创造出来的套利交易增量可能更大。
因此,在这种网络结构下:
大小交易所既是竞争者,又可能是互补者。
这就解释了为什么大型交易所没有简单地“吞掉”所有小型交易所。
六、所以,加密市场碎片化只是因为行业还年轻吗?
张翼东给出的答案是否定的。
一种常见观点认为:
现在交易所很多,只不过是因为加密行业还处于早期。
经历长期竞争之后,最终也会像传统金融一样,只剩下几家寡头。
但这项研究提出了不同判断:
交易所碎片化并不只是一个暂时性的行业发展阶段,而是与加密货币市场的底层经济结构有关。
原因在于,只要以下三个条件长期存在:
- 全球拥有不同的法币体系;
- 各国拥有不同的金融监管制度;
- 用户仍然需要通过本地银行体系进入加密资产市场;
交易所就仍然需要承担“连接本地金融体系和全球加密网络”的职能。
因此,本地化交易所存在长期经济价值。
研究因此判断,由大量本地交易所组成、再通过少数大型中心连接起来的市场结构,很可能在相当长时间内持续存在。
七、DEX 为什么反而可能比 CEX 更集中?
这个理论还有一个很有意思的验证。
如果造成交易所碎片化的主要原因真的是区块链转账本身,那么去中心化交易所(DEX)应该比中心化交易所更加碎片化。
但现实可能恰恰相反。
张翼东指出,在以太坊内部,DEX 市场的集中程度实际上更高,例如 Uniswap 可以拥有非常强的市场地位。
原因也符合这套理论:
链上交易没有那么严重的法币和司法管辖区壁垒。
如果大家都使用相同的 ERC-20 资产和 USDC 交易,就没有必要为了连接美元、澳元、日元以及不同国家的银行系统,而建立大量地方性市场。
因此,这项研究强调:
真正造成全球 CEX 市场碎片化的核心摩擦,并不是区块链本身,而是链下世界的法币、银行和监管体系。
八、这项研究真正揭示了什么?
从更大的角度看,这项研究揭示了加密市场一个非常有意思的“去中心化悖论”。
区块链技术降低了资产本身的跨地域流通成本。
但只要这些资产最终还需要与银行、法币、监管机构和现实世界连接,市场就无法真正摆脱地域和制度摩擦。
结果就是两个力量同时存在:
司法管辖区和法币体系推动市场碎片化;
流动性和套利网络又推动市场形成少数中心。最终形成的并不是完全去中心化的网络,也不是一家交易所垄断全球,而是:
“大量外围节点 + 少数超级枢纽”的星形结构。
这也解释了一个看似矛盾的现实:
为什么加密货币本身可以全球自由流动,而交易加密货币的平台却长期呈现碎片化;为什么 Binance 这样的巨头不断壮大,却仍然没有消灭成百上千家小型交易所。
市场的真正边界并不完全存在于区块链上。
很多时候,它存在于银行账户、法币体系、监管制度以及不同司法管辖区之间。
而这可能正是理解加密货币市场结构最关键的一点。
- ZZethes Post #267
张一鸣访谈
一家依靠新技术迅速成长的平台公司,如何理解自己的机会、竞争优势,以及规模越来越大之后应承担什么责任?
1. 第一层:平台公司一旦足够大,就不再只是普通商业公司
张一鸣的一个核心判断是:科技平台随着用户规模扩大、技术杠杆增强,最后会越来越像一种“基础设施”。
普通企业主要影响员工、客户、上下游;平台公司却可能影响几亿人的信息获取、内容生产和日常生活。如果又是全球平台,影响还会跨越多个国家。因此,它不能只满足于“法律允许、商业上赚钱”,而应该承担高于普通公司的责任。
这是理解整篇对话非常关键的一点:
技术 → 规模效应 → 社会影响力 → 公共属性 → 更高责任。
所以张一鸣后来把平台责任大致分成了几层:
- 技术创新责任:科技公司首先要持续用技术创造价值;
- 内容生态责任:不能只消费内容生态,还要促进原创内容生产;
- 公共信息服务责任:例如“头条寻人”,即使不是法律要求,也应该利用平台能力解决社会问题;
- 平台治理责任:包括虚假信息、标题党、未成年人沉迷等问题。
最值得注意的,是他说平台企业应该主动提高透明度,主动和监管者、公众沟通,把这看作大型科技平台的“必修课”。
这其实已经触及今天所有大型互联网平台都会面对的问题:当企业事实上拥有了公共基础设施式的权力时,它是否还能只用“私人企业”来定义自己?
2. 第二层:创业机会不是“找到最赚钱的赛道”,而是看见别人没有看见的东西
接下来钱颖一问:年轻人创业,究竟应该寻找什么样的机会?
张一鸣的回答不是“研究哪个行业增长最快”,反而认为:
如果一个机会已经表现为“市场巨大、利润丰厚、所有人都知道”,那它往往已经是显然之物,别人也会涌进去。
真正有价值的创业机会,是:你用和别人不同的视角观察世界,比别人早半步看到某种变化。
而且他提出了一个很重要的判断标准:创业最好不是简单抢走别人已有的市场份额,而是给社会创造新的“增量”。也就是说,不只是:我怎样打败竞争对手?
而是:我有没有创造一种原来不存在的价值?
这接近经济学里的正和创新。
3. 为什么他反复强调“兴趣”和“志向”?
这里很容易被误解成鸡汤。
他的逻辑实际上非常现实。
一个新行业一定会经历:兴起 → 过热 → 质疑 → 波动 → 调整。
如果一个人进入行业只是因为“现在很火”“赚钱很多”,一旦行业遇冷,就很容易退出。
但如果你进入,是因为你真正相信自己看到的趋势,那么外界的短期变化不容易让你改变判断。张一鸣明确把兴趣和坚持联系起来:只有相信自己看到的东西,才更可能穿越行业和舆论波动。
钱颖一随后把这个观点总结得很好:别人因为环境变化而改变,而真正的兴趣与志向有时会使你在别人改变的时候仍然坚持。
所以这里的“兴趣”,真正指的不是:“我喜欢做什么。”
而更接近:“什么事情值得我在五年、十年的不确定性中持续投入?”
4. 第三层:为什么字节跳动这么早就全球化?
这是整篇里最有战略含量的一部分。今日头条 2012 年上线,到 2015 年左右就已经开始全球化。钱颖一问:为什么这么着急?
张一鸣给出的第一个原因是一个非常重要的时间窗口判断:
过去一代中国互联网公司往往比美国企业晚两三年,因此主要模式是:Copy to China。
先在美国验证,再复制到中国。
但移动互联网这一代,中国和海外公司第一次在很多领域接近同步起跑。
这意味着竞争规则变了。以前:国外创新 → 中国本土化。
现在:同一个技术浪潮 → 全球企业同时竞争。
于是字节从一开始就不能只把自己看成“中国互联网公司”。
5. 全球化真正的逻辑不是“多赚几个国家的钱”,而是规模经济
张一鸣后面的解释实际上非常经济学。
互联网业务有一个特点:边际成本很低。
软件、推荐算法、基础技术研发完成之后,再增加一个用户的成本远低于传统工业企业。
因此谁能够服务更大的全球市场,谁就能够把同样的研发投入摊到更多用户身上。
所以他说,如果竞争对手面对的是数倍于你的市场规模,长期竞争会非常困难。全球竞争要求企业能够配置全球的:
- 市场;
- 组织;
- 人才资源。
因此全球化不是一个“国际业务部门”,而是整个公司的竞争结构。
可以把它写成一个非常简单的模型:
全球用户规模 ↑
→ 固定研发成本被更多用户分摊
→ 单位成本 ↓
→ 数据/产品迭代能力 ↑
→ 竞争力 ↑这就是互联网时代的全球规模效应。
6. 字节全球化最核心的产品哲学:“全球产品,本地内容”
这里尤其值得注意。
传统国际化经常是:去日本做日本版,去印度做印度版,去巴西再开发一个巴西版。
张一鸣不想采用这种方式。
他的设想是建设一个统一的全球平台,但是:产品和技术尽量全球统一,内容和运营高度本地化。
他用了一个很形象的比喻:平台像“杯子”,内容像里面的“饮料”。
不同国家喝的饮料不一样,但杯子的基本结构可以相同。
换成今天更熟悉的语言就是:全球统一技术底座 + 本地化内容生态。
推荐系统尤其适合这种模式。
因为推荐算法不需要预先假定:
日本人一定喜欢 A,中国人一定喜欢 B。
理论上它可以根据每个市场、每个用户的实际行为不断学习。
所以字节全球化背后并不仅仅是商业野心,而是一个技术判断:
算法型产品天然具有比传统内容产品更强的跨文化扩张能力。
这一点后来确实成为 TikTok 全球扩张的重要产品逻辑,但这是根据后续发展作出的历史观察,并非这份对话原文进一步展开的内容。
7. 第四层:互联网“赢家通吃”,是不是意味着年轻人已经没有创业机会?
这是钱颖一作为经济学家提出的最尖锐的问题。
平台经济确实存在很强的:
Winner-takes-all(赢家通吃)效应。
原因包括:
- 网络效应;
- 数据规模;
- 用户规模;
- 品牌;
- 资本;
- 技术基础设施。
于是会产生一个悖论:
BAT 越成功,后来创业者是不是越没机会?
钱颖一直接把这个问题摆出来了。
张一鸣的回答不是否认规模效应。
他承认:
- 领先平台不能滥用规模优势;
- 法律和行业治理要维持竞争环境。
但是他认为还有一种力量比规模效应更强:
创新。
8. 为什么大公司很强,创业公司仍然可能出现?
因为技术范式发生变化时,原有优势会部分失效。
这是整篇最值得记住的一个模型。
张一鸣用“地壳运动”来形容技术革命:当环境相对稳定时,成熟企业占优势。
但当计算机、互联网、移动互联网这样的重大技术出现之后,相当于整个生态环境突然发生变化。
于是:旧物种的优势下降,新物种获得快速扩张的机会。
今日头条、美团等公司的崛起,在他的解释里都与移动互联网浪潮密切相关。
所以创业机会可以理解成:新技术 × 新需求 × 原有巨头暂时没有适应的窗口。
这也解释了他说的“领先半步”。
不是领先十年。领先十年往往意味着基础设施还不存在。
也不能落后半步。因为别人已经占据市场。
真正好的创业窗口通常是:
趋势已经出现,但大多数人还没有充分意识到它的重要性。
9. 第五层:为什么成熟公司反而应该“保持年轻”?
最后这部分看似在聊年轻用户,实际上是在讲一个大型组织最危险的问题:认知老化。
公司成功以后,人会形成大量经验。
经验本来是优势,但有一个副作用:
看到一种新东西时,很容易说:
“这个没意义。”
“年轻人才喜欢。”
“以前已经有人做过了。”
“这个模式不成立。”
张一鸣的答案恰恰相反:公司不应该一味追求“成熟”,而应该保持年轻,不要轻易否定新事物;一个东西既然出现并流行,就应该先体验、尝试,再观察它为什么出现。
真正危险的不是不知道,而是用旧知识过早解释新事物。
- ZZethes Post #268
怀孕会对女性大脑产生怎样的影响?
从“孕傻”到一次持续数年的大脑重塑
原文出处:返朴科普
原文发布日期:2024 年 10 月 29 日 17:01
原作者:徐斯佳扩展说明:本文在保留原文出处的基础上,根据相关原始论文对研究方法、数据、机制解释及研究局限进行了补充和校订。
“一孕傻三年”,大概是有关怀孕最深入人心的俗语之一。
不少女性在怀孕和产后确实会感觉自己更健忘了:刚拿起手机就忘记要做什么,出门后想不起有没有锁门,说到一半的话突然“卡壳”,工作时也似乎更容易分心。这种现象在英语里甚至有专门的通俗叫法——“pregnancy brain”或者“baby brain”。
那么,怀孕真的会让女性“变傻”吗?
答案比一句“会”或者“不会”复杂得多。
现有研究的确发现,妊娠期间女性的大脑会发生相当显著的结构重塑;一些认知研究也观察到记忆等能力出现轻微变化。但“大脑结构改变”并不等于“大脑退化”,灰质减少也不能简单理解为神经元大量死亡。更没有证据证明,每个女性都会因为怀孕而出现持续整整三年的智力下降。
更准确地说,怀孕可能是成年女性一生中幅度最大的神经可塑性事件之一。
2024 年 9 月 16 日,美国加利福尼亚大学圣芭芭拉分校等机构的研究人员在《Nature Neuroscience》发表了一项颇受关注的研究:他们以前所未有的时间密度,记录了一名女性从怀孕前、整个妊娠期一直到产后两年的大脑变化,为科学家第一次观察“正在怀孕的大脑如何逐周改变”提供了详细地图。[1]
不只是肚子变大:怀孕首先是一场剧烈的内分泌事件
人的妊娠期大约持续 40 周。
在这段时间里,母体需要同时维持自身生命活动和胎儿发育,因此几乎所有主要生理系统都会发生调整:血浆容量增加,心输出量发生改变,代谢率和氧气消耗上升,免疫系统被重新调节,水和电解质平衡也随之改变。
而推动这一系列变化的核心力量之一,就是激素。
妊娠期间,胎盘和母体内分泌系统产生大量雌激素和孕激素,其合成量相比非妊娠状态可以增加数百甚至上千倍。雌激素和孕激素并不仅仅作用于子宫、乳腺和生殖系统,它们本身也是重要的神经调节因子,能够影响突触、胶质细胞、髓鞘以及多个神经环路。
在 Pritschet 等人的研究中,受试者血液中的激素变化非常明显。例如在研究所测时间点中,雌二醇从孕前的 3.42 pg/ml升至分娩前约3周的12,400 pg/ml,孕激素则从0.84 ng/ml升至103 ng/ml;分娩后两者又迅速下降。
换句话说,大脑在妊娠期间面对的是一个极其特殊的生化环境。
科学家真正想知道的是:
这样剧烈而持续的激素变化,会不会重新“雕刻”成年人的大脑?
答案是,会。
26 次扫描,第一次把一颗大脑从孕前追踪到产后两年
过去研究妊娠大脑最大的困难,是时间。
很多研究只能在怀孕前扫描一次,再在分娩几个月后扫描一次。这样虽然能够看到“两张照片之间发生了变化”,却无法知道变化究竟从什么时候开始、以什么速度发展,又是在怀孕、分娩还是产后发生的。
Pritschet 团队采用了一种所谓的**高密度个体纵向成像(precision imaging)**策略。
研究对象是一名 38 岁的健康初产妇,通过体外受精(IVF)怀孕,因此研究人员可以非常精确地确定排卵、受孕以及孕周。
从受孕前 3 周到产后 2 年,她一共进行了 26 次 MRI 扫描:
孕前 4 次,孕早期 4 次,孕中期 6 次,孕晚期 5 次,产后 7 次。
研究同时进行了多次血液激素测定。
需要特别说明的是,这项 2024 年研究的核心技术是结构 MRI 和弥散成像,用来测量灰质、皮质厚度、脑室、脑脊液以及白质微结构等指标,而不是主要依靠功能磁共振成像(fMRI)。
如此密集地扫描同一个人,使科学家第一次得以像观看“延时摄影”一样观察一颗人类大脑如何随着孕周推进而发生改变。
最醒目的变化:灰质减少,皮质逐渐变薄
结果相当明显。
随着妊娠推进,受试者的总脑体积、灰质体积以及平均皮质厚度均逐渐下降。
而且这种变化并非集中在一两个小区域。
研究人员把大脑皮层划分成 400 个区域后发现,其中约80% 的区域,其灰质体积都与孕周呈负相关。从孕前到孕 36 周的灰质变化幅度,也明显超过一般人在数月时间里的正常测量波动。
变化尤其明显的区域涉及多个大型脑网络,包括控制网络、显著性/腹侧注意网络、背侧注意网络、默认模式网络以及躯体运动网络。
具体到解剖区域,则涉及岛叶、前额叶、后扣带皮层、顶下小叶、中央后回以及感觉运动皮层等。
因此,怀孕带来的并不是某个孤立“记忆中枢”缩水,而是一场覆盖范围相当广的大脑结构重塑。
海马体也会变化,但这不能直接等同于“记忆变差”
除了大脑皮层,研究人员还发现多个皮层下区域发生了变化。
包括丘脑、尾状核、腹侧间脑、部分壳核以及海马等区域,其体积都随着妊娠进展而下降。
利用更高分辨率的分析,研究人员进一步发现,海马并不是整体以完全相同的方式改变:CA1、CA2/CA3 以及邻近的海马旁皮层出现了较明显的体积下降,而其他部分则相对稳定。
海马与学习和记忆密切相关,因此这一发现很容易让人联想到孕妇经常抱怨的“忘事”。
但这里必须避免一个常见的逻辑跳跃:
“海马体积变小”并不等于“记忆能力按比例下降”。
MRI 测出来的灰质体积是一个宏观指标,它受到神经元、树突、突触、胶质细胞、血管、组织含水量和细胞外空间等许多因素影响。
MRI 无法告诉我们:“这里少了多少个神经元。”
实际上,研究作者明确提出,孕期出现的脑室和脑脊液变化提示,体液和组织含水量变化可能解释一部分 MRI 测量结果;与此同时,一些变化持续到产后较长时间,又提示其中可能确实存在突触、胶质细胞、髓鞘等层面的长期神经可塑性。
因此,与其把这种现象称为“大脑萎缩”,不如称为大脑重塑。
“少一点”未必是坏事,大脑发育本来就不等于越大越好
我们很容易形成一种直觉:
大脑体积增加就是好事,减少就是坏事。
但神经科学并不是这样运作的。
青少年发育就是一个典型例子。在青春期,部分皮层也会出现灰质减少和皮质变薄,与此同时,认知控制、社会认知和执行功能却在持续成熟。
其中一个可能原因是,神经系统会对连接进行重新组织和“精细调节”:部分低效率或者冗余连接被削弱,同时重要通路得到强化。
研究人员因此提出,妊娠期间观察到的灰质减少,也可能体现一种类似的fine-tuning——精细调节过程。
早期人类研究已经发现,妊娠后灰质减少尤其明显地涉及社会认知相关区域,而且部分结构变化与母亲对婴儿的依恋和对自己孩子刺激的脑反应有关。[3]
但目前这仍然主要是一个神经生物学假说。
我们可以说妊娠似乎正在“重新配置”大脑,却还不能说科学家已经知道每一处灰质改变具体承担什么功能。
有趣的是,灰质在减少,白质却一度变得更加“有序”
与此同时,大脑里出现了一个方向几乎相反的变化。
白质主要由连接不同脑区的神经纤维组成,可以把它大致理解为大脑内部远距离通信的“线路”。
利用弥散 MRI,研究人员测量了一项名为**定量各向异性(quantitative anisotropy,QA)**的白质微结构指标。
结果显示,在怀孕早期和中期,全脑多条白质通路的 QA 逐渐升高,包括胼胝体、弓状束、下额枕束、下纵束、扣带束以及皮质脊髓束等。到产后,这种变化又迅速回到接近孕前水平。
这说明灰质和白质并不是同步朝一个方向改变。
不过,“QA 增加”也不能简单翻译成“大脑线路升级”或者“传递速度变快”。它反映的是弥散 MRI 下白质纤维微结构和方向性的变化,只能间接提示组织结构发生了调整。
更有意思的是,这种白质变化是暂时的。
如果研究者只在“怀孕前”和“产后几个月”各扫描一次,很可能根本看不到它。
这正是高密度纵向扫描的价值:怀孕的大脑并不是从 A 状态一次性跳到 B 状态,而是在不断变化。
分娩以后,大脑开始“往回走”,但不同区域恢复速度并不一样
Pritschet 团队继续追踪受试者直到产后两年。
结果显示,分娩以后,灰质体积和皮质厚度确实出现了一定程度的恢复,但整体只表现为部分回升;一些指标到产后两年仍没有完全回到孕前水平。
相比之下,白质 QA 变化恢复得更快。
这恰好与 2024 年 1 月发表在同一期刊上的另一项大规模研究互相补充。
西班牙研究团队对 110 名第一次怀孕的女性进行了纵向研究,并设置 34 名未生育女性作为对照。孕妇第一次 MRI 检查平均在孕 36.2 周,第二次检查则平均在产后 22 天左右。
研究人员又在另外 29 名母亲和 24 名对照女性中进行了独立重复验证。[2]
结果同样显示:
临近分娩时,孕妇的整体皮层体积和皮层厚度低于未怀孕对照;而到了产后早期,皮层体积、厚度和表面积已经开始增加。
也就是说,大脑很可能呈现这样一条动态轨迹:
怀孕期间逐渐下降 → 分娩附近达到低点 → 产后开始回升。
但有些高级脑网络似乎恢复得更慢
并不是所有大脑区域都以同样速度“反弹”。
西班牙团队把结构变化与经典的大尺度功能脑网络进行对应后发现,孕晚期几乎所有主要网络的皮层体积都较低。
进入产后以后,注意相关网络的恢复相对明显,而默认模式网络和额顶网络的恢复幅度低于预期。
默认模式网络涉及自我相关思考、社会认知、推测他人心理状态等高级认知过程。
过去的研究还发现,默认模式网络中的某些妊娠相关结构变化在产后 1 年、2 年乃至 6 年后仍然可以检测到。
这也是为什么科学家越来越倾向于把妊娠看成一次重要的成年期神经发育转变,而不仅仅是一段短暂的生理状态。
有研究者甚至使用**matrescence(母职转变期)**这一概念,将成为母亲的过程视为类似青春期的一种人生发展阶段:激素、身体、心理、社会角色和大脑在同一时间发生剧烈变化。
那么,“一孕傻三年”真的成立吗?
到这里,我们终于可以回到最初的问题。
答案是:
“孕傻”并非完全没有研究依据,但“一孕傻三年”不是目前科学研究能够支持的结论。
2018 年,一项针对 20 项研究、共 709 名孕妇和 521 名非孕女性的荟萃分析发现,孕妇在总体认知、记忆和部分执行功能测试中的平均成绩确实较低,其中差异在妊娠晚期更加明显。[4]
但这一领域的研究结果异质性很高。
后续综述认为,如果孕期认知变化确实存在,其平均效应通常不算巨大,对日常生活实际影响多大也仍有争议。
更重要的是,不能把这些认知实验结果与 2024 年的脑结构研究直接画等号。
在西班牙团队的 110 名母亲中,研究人员同时测量了睡眠、压力、抑郁症状、焦虑和母婴依恋等变量。
结果显示,产后母亲的睡眠和压力的确发生了明显变化,但是研究人员没有发现整体皮层结构改变的幅度与这些神经心理指标之间存在显著相关性。
也就是说,目前没有证据证明:
“灰质减少了多少,就会忘事多少。”
很多“孕傻”,可能并不只来自大脑结构
事实上,一个孕妇或者新手妈妈同时面对的变量太多了。
妊娠晚期可能出现睡眠中断、夜尿、腰背痛、胃食管反流;产后则可能出现频繁夜醒、哺乳、恢复期疼痛以及长时间睡眠不足。
与此同时,新生儿带来了巨大的认知负荷。
喂奶时间、睡眠时间、疫苗、尿布、体温、哭声、工作、家庭事务……
一个人需要同时跟踪的信息骤然增加。
于是,日常生活里经常出现一种情况:需要记住的事情比以前多了,而可支配的注意资源和睡眠却比以前少了。
这完全可以造成非常真实的“脑子不够用”的体验,而无需假定人的智力真的下降了。
因此所谓“孕傻”很可能同时包含激素变化、大脑可塑性、睡眠、压力、注意力重新分配以及生活负荷改变等多重因素。
怀孕的大脑,可能正在重新确定“什么最重要”
从进化角度来看,这种改变并不难理解。
婴儿出生以后,照料者需要迅速识别婴儿的面孔、哭声、气味和情绪状态,需要提高对潜在威胁的警觉,同时还要形成强烈而持久的亲子依恋。
动物研究已经显示,妊娠激素能够重塑与亲代行为有关的神经环路。
在人类中,妊娠相关改变则涉及显著性网络、注意网络、默认模式网络以及部分与社会认知有关的脑区。白质方面,连接视觉、情绪和社会信息处理区域的一些长距离纤维束也出现明显变化。
一种颇有吸引力的解释因此是:
妊娠并不是简单让大脑“损失”了一部分功能,而是在重新配置资源,使大脑更适应即将出现的育儿任务。
但需要强调,这目前仍然属于具有生物学依据的解释,而不是已经得到完整验证的因果结论。
科学家还无法指着某一处发生变化的脑组织说:
“这部分缩小,就是为了让母亲更爱孩子。”
分娩方式会不会影响大脑?有线索,但远没有定论
西班牙研究还得到一个很有意思的结果。
110 名母亲中,99 人在分娩过程中经历了产程,其中包括阴道分娩者以及开始产程后转为紧急剖宫产的人;另有 11 人接受了没有进入产程的计划性剖宫产。
研究发现,计划性剖宫产组从孕晚期到产后早期的整体皮层体积、厚度和表面积增加幅度更大。
但这并不能解释成“剖宫产让大脑恢复更好”。
首先,计划性剖宫产只有 11 人,样本非常小;其次,阴道分娩与经历产程后紧急剖宫产的女性之间没有检测到明显差异。
因此研究者更关注的可能不是“从哪里把孩子生出来”,而是有没有经历产程本身所伴随的激素、炎症和免疫变化。
这一发现目前只能称为线索,需要更大的样本进一步确认。
最大的问题仍然是:最精细的那张地图,只有一个人
Pritschet 等人的研究有一个非常鲜明的特点:
它在时间维度上异常精细,但样本量只有 1 人。
这种研究设计和传统的大样本研究解决的是两个不同问题。
大样本研究擅长回答:
“平均而言,孕妇和非孕女性有什么区别?”
而这种精密个体成像擅长回答:
“在一个真实的人身上,这种变化究竟什么时候开始、如何发展?”
研究者还使用 8 名接受过密集扫描的非孕成年人作为参照,发现孕期灰质变化幅度远远超过一般的日常或测量波动。这说明研究看到的变化很可能是真实的,而不是 MRI 机器偶然产生的误差。
但一个人的变化不能代表所有人。
这名受试者 38 岁、健康、第一次怀孕、通过 IVF 受孕、足月阴道分娩,并持续母乳喂养到产后 16 个月。
年龄、遗传、怀孕次数、自然受孕还是辅助生殖、胎儿性别、睡眠、社会经济状况、妊娠并发症、是否哺乳以及产后心理状态,都可能影响大脑变化。
所以这项工作的真正意义,不是宣布“所有女性怀孕后大脑都会缩小这么多”,而是证明:
妊娠期间的人类大脑可以发生此前没有被完整记录过的大规模、动态而且高度有序的改变。
“变傻”或许不是理解这种变化的最好方式
过去,人们谈到怀孕对大脑的影响,经常从“损失”的角度出发:
记忆下降了,注意力下降了,大脑体积减少了。
但神经科学正在提供另一种视角。
怀孕可能是一场深刻的成年大脑重塑。
一部分灰质减少,一部分区域相对稳定;一些白质指标暂时升高;脑室和脑脊液发生变化;部分结构产后快速恢复,另一些改变持续多年。
这幅图景更像一次复杂的系统重构,而不是简单的“性能下降”。
真正值得研究的,也许不是:
“怀孕会不会让女性变笨?”
而是:
“为了完成妊娠、分娩并适应照料婴儿这一全新的生命任务,成年人的大脑究竟进行了怎样的重新配置?”
这些研究还可能具有重要的临床意义。
如果未来能够建立正常妊娠和产后的“大脑变化参考曲线”,科学家就有可能进一步判断哪些变化属于正常的母体适应,哪些变化可能与围产期抑郁、先兆子痫、癫痫、头痛以及其他孕产期神经系统疾病有关。
这也是研究母体大脑最终最重要的意义:
不是为“一孕傻三年”寻找一个漂亮的科学解释,而是理解女性在生命中最剧烈的一次生理转变期间,大脑究竟发生了什么,以及什么时候这些变化需要医学上的关注。
参考文献
-
Pritschet, L., Taylor, C. M., Cossio, D., Faskowitz, J., Santander, T., Handwerker, D. A., et al. Neuroanatomical changes observed over the course of a human pregnancy. Nature Neuroscience, 27, 2253–2260 (2024). DOI: 10.1038/s41593-024-01741-0.
-
Paternina-Die, M., Martínez-García, M., Martín de Blas, D., Noguero, I., Servin-Barthet, C., Pretus, C., et al. Women’s neuroplasticity during gestation, childbirth and postpartum. Nature Neuroscience, 27, 319–327 (2024). DOI: 10.1038/s41593-023-01513-2.
-
Hoekzema, E., et al. Pregnancy leads to long-lasting changes in human brain structure. Nature Neuroscience, 20, 287–296 (2017). DOI: 10.1038/nn.4458.
-
Davies, S. J., Lum, J. A. G., Skouteris, H., Byrne, L. K. & Hayden, M. J. Cognitive impairment during pregnancy: a meta-analysis. Medical Journal of Australia, 208, 35–40 (2018). DOI: 10.5694/mja17.00131.
-
Servin-Barthet, C., Martínez-García, M., Pretus, C., et al. The transition to motherhood: linking hormones, brain and behaviour. Nature Reviews Neuroscience, 24, 605–619 (2023). DOI: 10.1038/s41583-023-00733-6.
-
 无状态垃圾桶 Post #12
FYI,我还在用
kr.pig2.de,主域名还有一些功能有问题,比如文件上传- ZZethes Post #183
《Left over or opting out? Squeeze, mismatch and surplus in Chinese marriage markets》(是被剩下还是主动退出?中国婚姻市场中的挤压、错配与剩余)
作者 Pauline Rossi 和 Yun Xiao 探讨了一个当前中国社会非常关注的核心问题:为什么中国的结婚率在过去二十年里出现了断崖式的下降?
1. 核心问题与三大假说
从 1999 年到 2019 年,中国单身男女在一年内结婚的概率(年度匹配率)几乎降低了一半:男性从 10.8% 降至 5.8%,女性从 18.5% 降至 9%。
为了解释这种现象,社会学和经济学界通常有三种主流解释(假说):
- 婚姻挤压(Marriage Squeeze): 即性别比例失衡。由于独生子女政策和传统的重男轻女观念,中国男性比女性多出约 3500 万。这导致大量底层男性找不到对象,被迫成为“剩男”(shengnan)。
- 婚姻错配(Marriage Mismatch): 即教育扩张带来的结构性矛盾。中国传统观念倾向于“女嫁高、男娶低”(女性向上婚)。但如今女性的受教育程度已经反超男性,导致高学历女性找不到“条件更好”的男性,从而产生“剩女”(shengnu)。
- 婚姻剩余下降(Decrease in Marriage Surplus): 这里的“剩余”是一个经济学概念,可以简单理解为 “结婚的好处” 。很多人认为“单身比结婚更爽”,因此主动选择“退出”婚姻(Opting out)。
这篇论文的目的,就是用数据算出:这三个原因,到底各自背了多少锅?
2. 研究方法与数据
- 数据来源: 2000 年人口普查(代表 1999 年市场)、2020 年人口普查及 CFPS 调查数据(代表 2019 年市场)。将人群按性别和学历分为两类:H(上过高中及以上)和 L(初中及以下)。
- 核心模型(Choo and Siow 模型): 这个模型的核心逻辑是:如果市场上某种类型的男女配对(比如高学历男配高学历女)数量很多,说明这种婚姻带来的“剩余(好处)”大。通过观察市场上的单身人数和最终结婚的人数,模型可以反推出 1999 年和 2019 年结婚的“真实意愿(婚姻剩余)”。
- 反事实模拟(Counterfactual Analysis): 作者做了一个假设:“如果 2019 年的人,对待婚姻的态度(结婚意愿)和 1999 年的人一模一样,但人口的性别比例和学历发生了变化,结婚率会变成多少?”通过这种模拟,就能剥离出人口结构变化和主观意愿变化各自的影响。
3. 核心发现一:人们对婚姻的“偏好”变了吗?
作者估算了不同类型婚姻的“婚姻剩余(结婚带来的好处)”,发现了非常有意思的现象:
- 整体结婚意愿在下降: 尤其是低学历男配低学历女(L-L)的婚姻,其“剩余”大幅下降了 28%。这打破了人们的一个刻板印象——不仅是高学历人群在拒绝结婚,低学历人群“主动不婚”的趋势实际上更猛烈。
- “女强男弱”的婚姻接受度在上升: 1999 年,低学历男配高学历女(L-H)是非常罕见且被排斥的。但在 2019 年,这种组合的“婚姻剩余”竟然上升了 12%。这说明,由于高学历女性太多,社会对“女性下嫁(向下婚)”的容忍度和接受度正在提高。
4. 核心发现二:结婚率下降的精确归因(重点)
通过模拟,作者精准量化了各个因素对结婚率下降的贡献:
对于男性(结婚率下降了 5 个百分点):
- 60% 的下降归咎于人口结构变化(被剩下): 其中,教育扩张及错配占了主要部分(46%),性别比例失衡(男多女少)占了 18%。
- 40% 的下降归咎于结婚意愿下降(主动退出)。
- 结论:男性结不了婚,主要是因为客观上找不到合适的(特别是低学历男性被挤出市场)。
对于女性(结婚率下降了 9.5 个百分点):
- 46% 的下降归咎于人口结构变化(被剩下): 有趣的是,对于女性来说,性别比例失衡(男多女少)其实是有利于女性找对象的(增加了 13% 的结婚率)。所以女性结构性结婚难,100% 是因为教育错配。
- 54% 的下降归咎于结婚意愿下降(主动退出)。
- 结论:女性结不了婚,更多是因为主观上觉得结婚没意思了,以及高学历女性不愿意将就(错配)。
关于“教育扩张”的进一步拆解:
为什么大家都受了教育,反而不结婚了?作者发现,教育因素带来的结婚率下降中:- 2/3 是因为“普遍推迟”: 书读得越多,进入婚姻的年龄就越晚(这属于正常现象)。
- 1/3 是因为“性别鸿沟(错配)”: 因为女性学历提升比男性快,导致高学历女性找不到同等或更高学历的男性,卡在了匹配环节。
5. 论文总结与现实意义
论文的标题巧妙地概括了中国的现状:Left over or opting out? (是被剩下还是主动退出?)
- 对于底层/低学历男性:他们主要是“Left over(被剩下)”的。 因为男多女少的绝对数量挤压,以及女性学历反超后的结构性挤压,他们成为了婚姻市场最底层的“剩男”。
- 对于高学历女性:她们主要是“Opting out(主动退出)”的。 她们面临着找对象难(错配)的问题,但更核心的是,她们觉得结婚带来的收益在减少,所以主动选择了单身。
未来展望:
论文在最后指出,随着时间推移,“男多女少”的挤压效应在未来 20-30 年会更加严重(因为之前积累的失衡人口会越来越多地进入婚姻市场)。但是,“错配”的矛盾可能会缓解,因为数据已经显示,年轻一代的女性和她们的父母,正在逐渐放弃“必须嫁得比自己好”的执念,“女性向下婚”正在变得越来越可接受。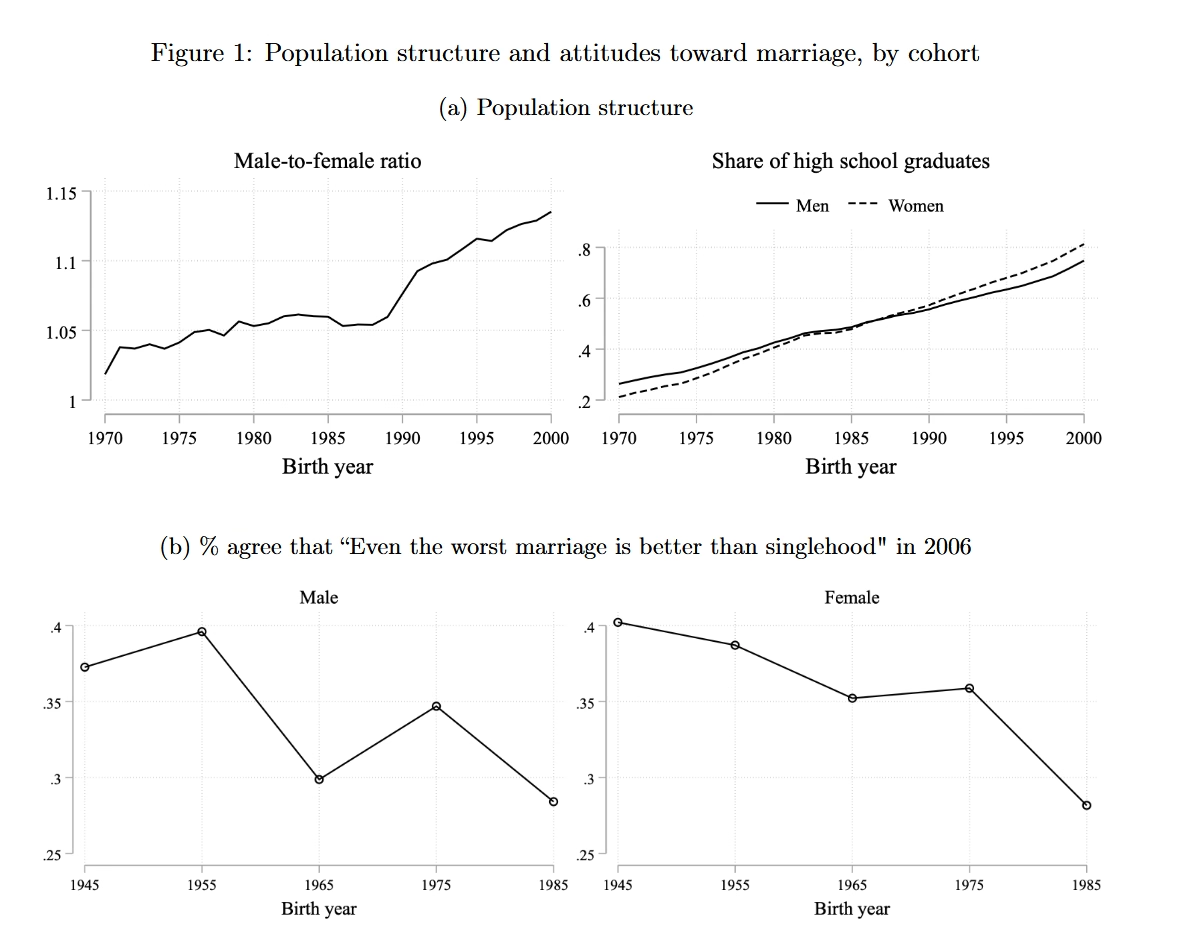
门当户对
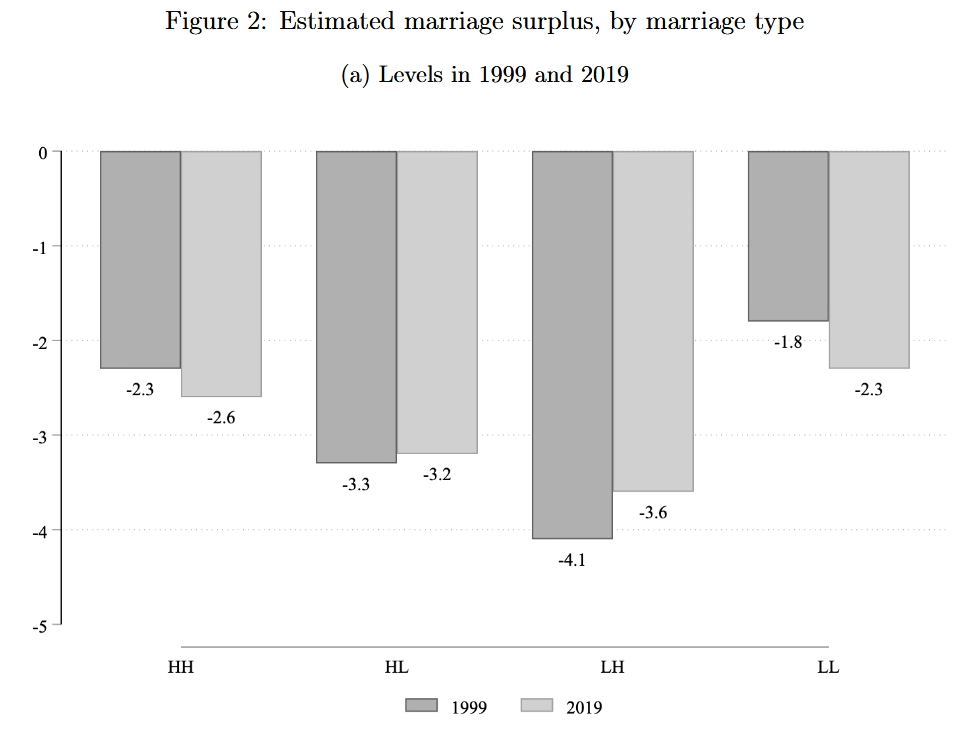
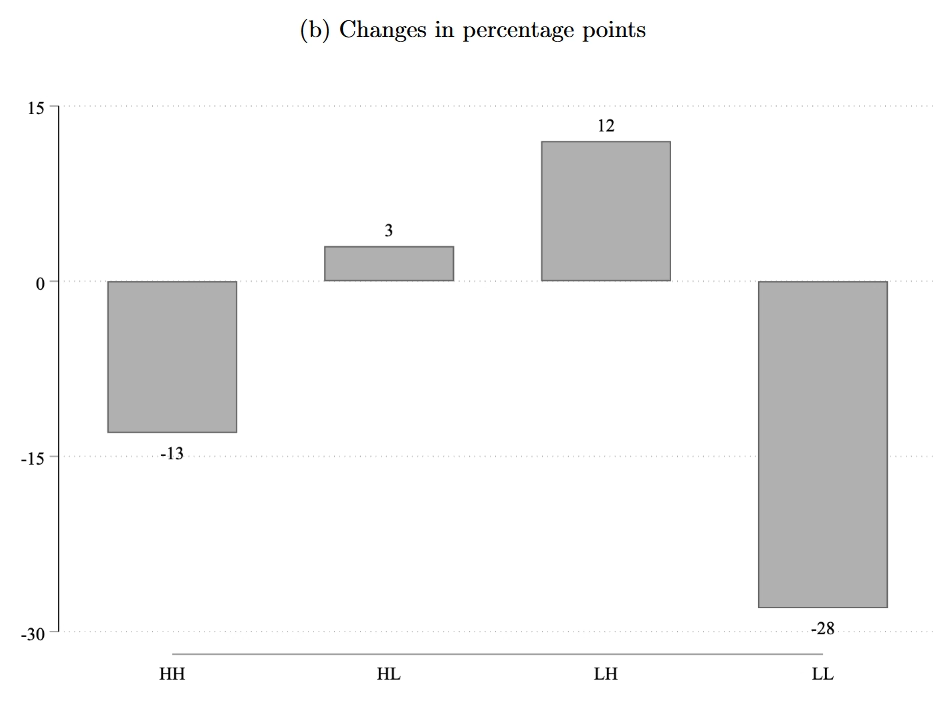
根据这篇论文的模型测算(见论文第 11 页的 4.1 Estimation 和第 22 页的图 2),HH(高学历男 + 高学历女) 和 LL(低学历男 + 低学历女) 是能产生最高“婚姻剩余”的组合。
1. HH 和 LL 是“最匹配、收益最高”的婚姻
经济学模型中的“婚姻剩余(Marriage Surplus)”,衡量的是 “结婚带来的系统性好处减去单身的好处”。剩余越高,说明人们越有动力去结成这种类型的婚姻。
作者通过数据算出了四种配对的婚姻剩余排序(注意:模型中数值越接近 0,代表剩余越高、结婚意愿越强):
- 1999 年的排序:LL (-1.8) > HH (-2.3) > HL (-3.3) > LH (-4.1)
- 2019 年的排序:LL (-2.3) > HH (-2.6) > HL (-3.2) > LH (-3.6)
可以看出,无论是在 1999 年还是 2019 年,LL(双低学历)和 HH(双高学历)的婚姻剩余都稳居前两名。
中国婚姻市场存在强烈的 “同质婚偏好”(Assortative matching) ,也就是我们常说的“门当户对”。人们在学历、阶层相似的情况下结合,价值观更容易契合,生活成本更容易分摊,因此双方感受到的“婚姻剩余(1 好处)”是最大的。
2. 动态来看:最“可靠”的组合,正在经历“缩水”
虽然 HH 和 LL 依然是目前最主流、剩余最高的婚姻形式,但作者在对比了 20 年的数据后,指出了一个严峻的问题:这两种原本最“可靠”的婚姻,其吸引力正在下降。
根据图 2(b) 的数据,从 1999 年到 2019 年:
- LL(双低学历)的婚姻剩余暴跌了 28% 这是所有组合中降幅最大的。过去,底层老百姓搭伙过日子(LL)能带来极大的生存效用和生育效用;但现在,即使是低学历人群,也越来越觉得“结婚不如单身好”。这打破了“只有高学历女性才不想结婚”的刻板印象。
- HH(双高学历)的婚姻剩余也下降了 13%。 高学历男女虽然还能门当户对,但由于职场压力、生育成本极高、以及双方都有极强的经济独立能力,导致“强强联合”带来的额外边际收益在减少,很多人选择主动退出(Opting out)。
3. 黑马:LH(低学历男 + 高学历女)的崛起
按照传统的中国观念,LH(低学历男 + 高学历女,即女性向下婚) 是最不被社会认可、最“不可靠”的婚姻。在 1999 年,它的婚姻剩余垫底(-4.1),在 2019 年也是垫底,说明人们极度排斥这种组合。
但令人惊讶的是,LH 是这 20 年间唯一一个“婚姻剩余”在上升(+12%)的组合!
论文解释:
因为高学历女性的数量已经大大超过了高学历男性(教育错配)。在找不到 HH(双高学历)的情况下,为了结婚,年轻一代的女性及其父母,正在逐渐放宽标准,减弱了对“女性下嫁”的排斥。 换句话说,由于现实的无奈,这种曾经最不被看好的婚姻组合,其“可行性和可接受度”反而提高了。女性向上择偶 vs 门当户对
1. 婚姻市场的第一优先级是“同质择偶”(门当户对)
论文在第 11 页明确指出:1999 年不同婚姻类型的婚姻剩余(Surplus)排序为 LH < HL < HH < LL。
作者得出的第一个结论就是:(i) there is a strong preference for assortative matching(人们对同质择偶/门当户对有强烈的偏好)。- HH(高学历男女)和 LL(低学历男女):属于夫妻双方学历对等的“同质婚姻”。双方教育背景相似,在价值观、交流方式和生活预期上更一致,因此产生的婚姻剩余(即结婚带来的系统性收益)更高。
- HL(高学历男 + 低学历女):虽然符合“男高女低”的传统,但在教育水平上属于“异质婚姻”(跨阶层匹配)。这种学历上的差距会削弱两人结合的整体收益。因此,HH > HL 是因为“门当户对”的吸引力超过了单纯的“男强女弱”。
2. “女性向上择偶”体现在哪里?体现在 HL 远大于 LH
如果我们想看“女性向上择偶”的传统是否起作用,不应该拿 HH 和 HL 比,而应该拿 HL(女方向上找) 和 LH(女方向下找) 进行对比。
论文指出,1999 年的排序是 LH < HL,并且在实际数据中(第 11 页),HL 的婚姻占比(9.5%)几乎是 LH(5%)的两倍。
作者对此的结论是:(iii) there is a strong distaste for female hypogamy(社会对女性向下择偶有强烈的排斥)。这完美地证明了“女性向上择偶”规律的存在:同样是学历不匹配的夫妻,社会和个人更能够接受“男高女低 (HL)”,而极度排斥“女高男低 (LH)”。
3. 动态变化:为什么现在会有“剩女”?
到了 2019 年,随着女性受教育程度的大幅提升(甚至反超男性),市场上出现了大量的高学历女性(H-type women)和低学历男性(L-type men)。
按照传统的择偶漏斗:
- 高学历女性首选高学历男性(追求 HH)。
- 但高学历男性不仅可以找高学历女性(HH),也可以找低学历女性(HL,符合男高女低传统)。
- 高学历女性非常排斥低学历男性(排斥 LH)。
结果就是:高学历女性在追求 HH 时,面临着一部分高学历男性流向 HL 市场的竞争;同时她们又不愿意妥协去接受 LH。 这就是论文中提到的 "Marriage mismatch"(婚姻错配),也是导致中国高学历女性“主动退出婚姻”(Opting out)或成为“剩女”(Leftover women)的核心结构性原因。
排序
- 最理想:门当户对(HH 或 LL)
- 可接受的妥协:女方高攀 / 男方低就(HL)
- 最受排斥的:女方低就 / 男方高攀(LH)
反事实模拟
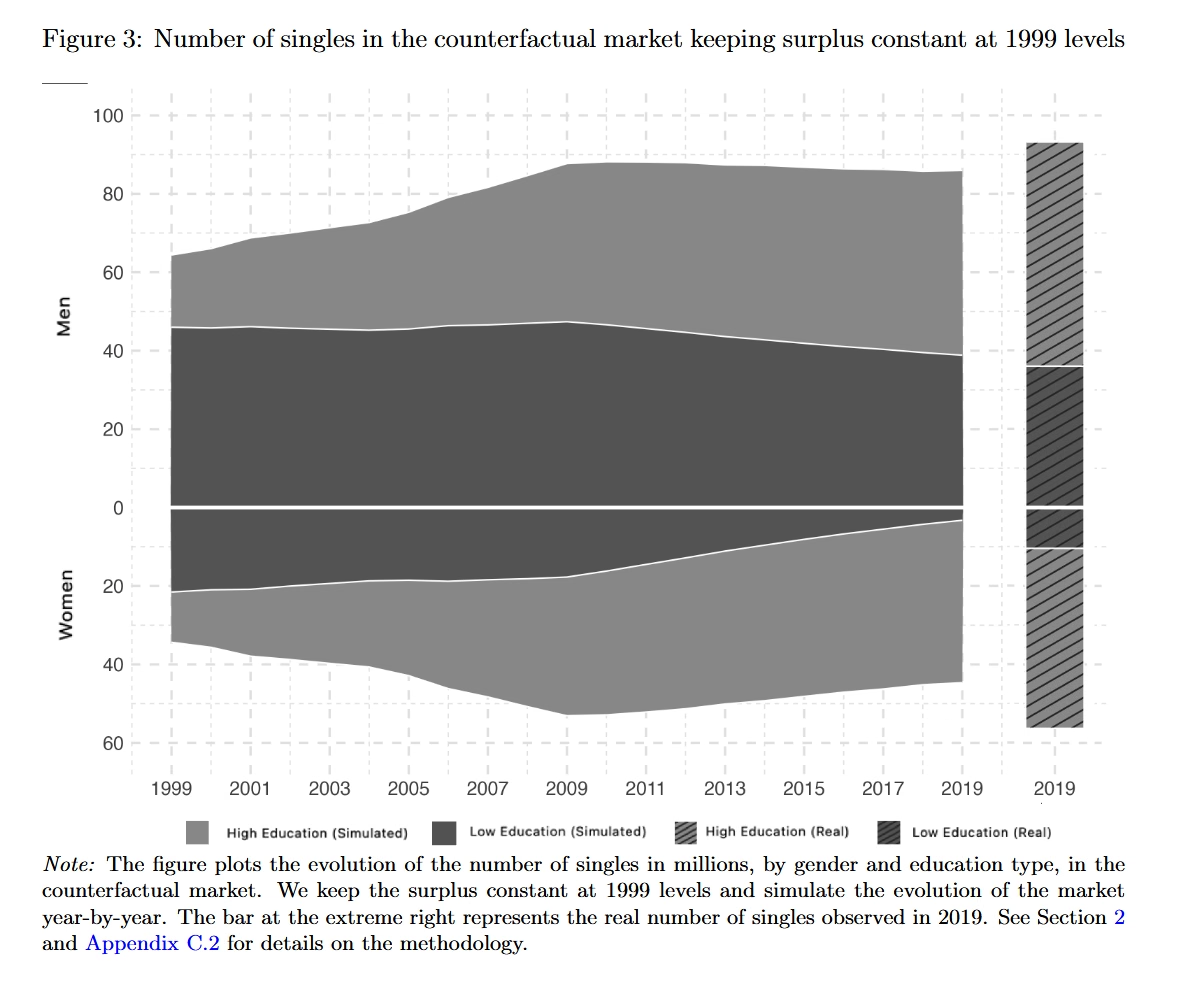
假设从 1999 年到 2019 年这 20 年里,中国人对婚姻的渴望程度(即“婚姻剩余/结婚意愿”)一点都没变,依然像 1999 年那样渴望结婚。唯一改变的,只有这 20 年里年轻人的“男女比例”和“学历水平”。 在这个“假设宇宙”里,单身人数会如何演变,并将其与 2019 年的“真实世界”进行对比。
一、读图
上半部分明显比下半部分厚,直观反映了中国“男多女少”的现实。
- 左边的大块面积(1999-2019): 这是模拟的“假设宇宙”。即保持 1999 年结婚意愿不变,每年加入新的人口数据推算出的单身人数。
- 最右边的阴影柱状图(2019): 这是 2019 年人口普查的**“残酷现实”**(真实的单身人数)。
- 颜色区分:
- 浅灰色(High Education): 高学历单身者(上过高中及以上)。
- 深灰色(Low Education): 低学历单身者(初中及以下)。
二、这张图揭示了哪三个惊人真相?
对比左边模拟结束时的状态(2019 年假设值)和最右边的柱子(2019 年真实值),我们可以看出以下结论:
1. 结论一:主动退出
- 看总高度: 最右边的真实柱子,无论是男是女,都明显高于左边模拟部分的结尾边界。
- 数据支撑: 如果大家的结婚意愿还停留在 1999 年,2019 年的单身总人数应该是 1.31 亿(左边灰色面积的末端)。但现实中,2019 年的单身人数是 1.5 亿(右边带斜线的柱子)。
- 说明了什么: 这多出来的近 2000 万单身人口,完全是因为“主观上不想结了”(也就是论文说的婚姻剩余/结婚好处下降了)。这证实了 “Opting out(主动退出婚姻)” 是一个巨大的时代推手。
2. 结论二:高学历男女单身数量“远超预期”
- 浅灰色部分: 真实世界里的高学历单身人数,比假设的要多得多(男性多了约 1000 万,女性多了约 4000 万)。
- 说明了什么: 虽然教育扩招导致高学历人群本身就变多了,但高学历人群主动选择不结婚的比例极其惊人。特别是高学历女性,大幅增加了单身阵营的厚度。
3. 结论三:低学历单身人数“不增反降”(一个反直觉的发现)
- 深灰色部分: 右边柱子的深灰色部分(真实低学历单身),其实比左边模拟的深灰色区域要窄(少)。
- 真实的低学历单身男性,比模拟的少了 300 万。
- 真实的低学历单身女性,比模拟的少了 700 万。
- 说明了什么:
如果一切还按 1999 年的规矩办,1999 年的人极度排斥“女高男低”(女性下嫁)。但到了 2019 年,因为高学历女性实在太多了,低学历男性反而“捡漏”了
这印证了论文前文的一个核心发现:社会对“女性向下婚(女高男低)”的包容度提升了。 高学历女性为了结婚,稍微放宽了标准,消化掉了一部分原本会打光棍的低学历男性。
- ZZethes Post #178
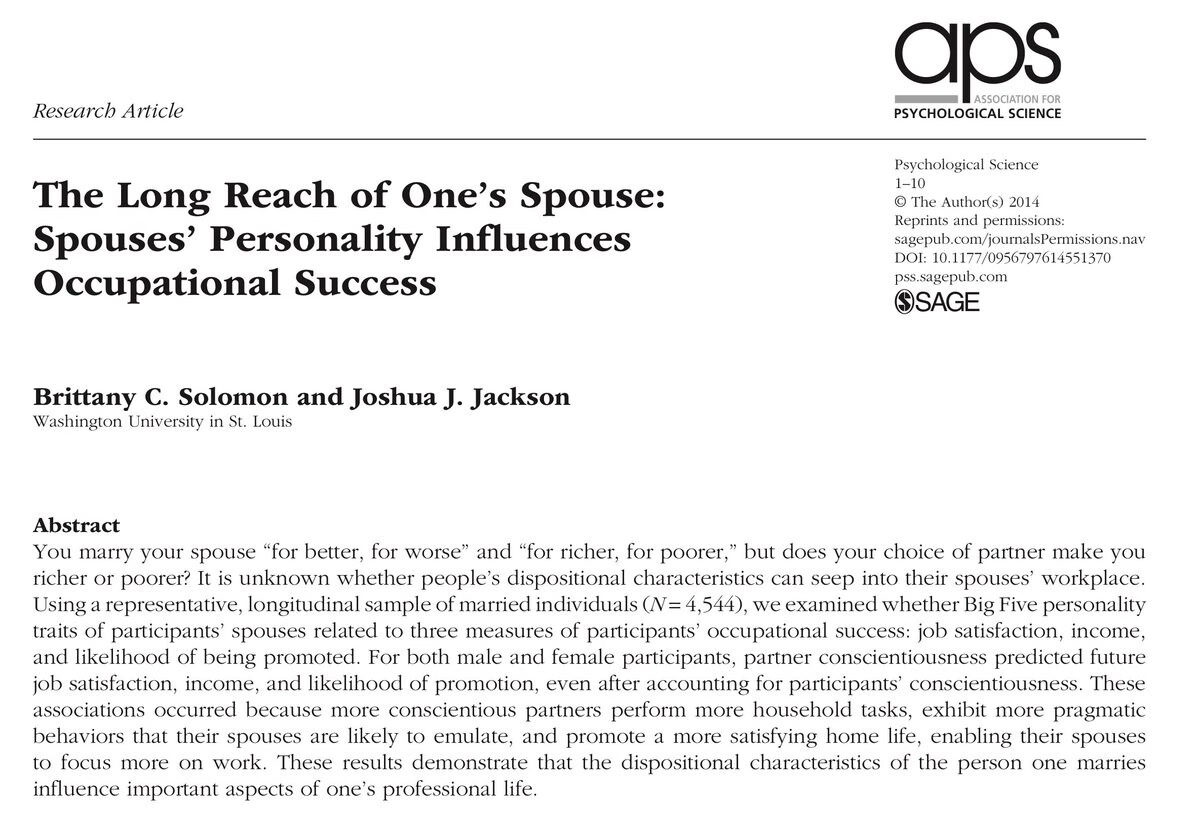
The Long Reach of One’s Spouse: Spouses’Personality Influences Occupational Success
作者是 Brittany C. Solomon 和 Joshua J. Jackson(华盛顿大学圣路易斯分校)。
你配偶的“尽责性”(conscientiousness)越高,你的职业表现(收入、升职概率、工作满意度)就越好——而且这个影响独立于你自己本身的尽责性。
1. 研究问了什么问题?
传统上我们知道:一个人的Big Five 人格特质(尤其是尽责性)会影响自己的工作表现。
但作者想知道更“远”的影响:
你另一半的人格,会不会“渗透”到你的职场里,影响你的收入、升职和工作满意度?结婚誓词说“无论贫富”,但现实中,娶/嫁的人格特质会不会真的让你更“富”或更“穷”?
2. 研究怎么做的?
- 样本:来自澳大利亚的全国代表性纵向数据(Household, Income and Labour Dynamics in Australia survey),已婚人士 N = 4,544 人。
- 时间跨度:纵向(追踪多年),所以能看“因果方向”(配偶人格 → 之后几年的职业结果)。
- 测量变量:
- 配偶的人格:Big Five(开放性、外向性、宜人性、神经质、尽责性)。
- 被试的职业成功(三种指标):
- 工作满意度(job satisfaction)
- 收入(income)
- 过去一年是否获得晋升(likelihood of promotion)
- 控制了什么?自己的人格(尤其是自己的尽责性)、年龄、教育、行业、双职工/单职工家庭等多种变量。
3. 最核心的发现
在控制了自己的人格之后,只有配偶的尽责性这一项特质,对三项职业结果都有显著的正向预测作用,而且对男性和女性都成立(性别对称)。
具体表现:
- 配偶尽责性越高 → 你未来几年:
- 工作更满意
- 收入更高
- 升职概率更大
其他四个人格特质(外向、开放、宜人、神经质)基本没有这种跨到职场的“长臂管辖”效应。
4. 为什么会这样?作者提出的三种机制
研究里做了中介分析,大概三种方式让“配偶高尽责性”帮到你的职业:
-
家务分工更合理(最重要的一条)
高尽责的配偶更愿意/更擅长承担家务(做饭、洗碗、打扫、跑腿、修东西、管账等)。
→ 你回家不用操心太多琐事,能把更多精力、时间、心力放在工作上(更少“心力分散”)。 -
行为模仿 / 社会学习
高尽责的伴侣日常表现出更多务实、有计划、靠谱的行为,你长期耳濡目染,也会不自觉地模仿一些好习惯(间接提升自己工作效率)。 -
更高的家庭生活满意度
高尽责伴侣让家庭氛围更稳定、更有秩序、矛盾更少,你整体生活满意度更高 → 情绪更稳定 → 工作状态更好。
注意:不是配偶直接帮你写报告、拉项目、替你加班,而是通过“创造更好的后方条件”,让你在前线(职场)打得更顺。
5. 数据上有多大影响?
- 配偶尽责性每提高 1 个标准差(sd),你的年收入大约增加几千美元(不同报道换算后大约 4000 美元左右,不同年份/国家有差异)。
- 如果配偶尽责性极高(比平均高 2sd),你获得晋升的概率比配偶极低尽责性的人高约 50%。
6. 现实意义
- 找对象不只是看“爱情”或“颜值”,人格(尤其是尽责性)可能是长期影响你人生天花板的重要变量之一。
- 职场成功不完全是你一个人的事,“后方稳定器”很重要。
- 对双职工家庭尤其有启发:家务分工不是小事,它会间接影响两个人的职业轨迹。
- 也提醒自己:提升自己的尽责性,不只对自己好,也是在帮伴侣的职业发展。
娶/嫁一个靠谱、有责任心、做事有条理的人,大概率是在给自己的职业生涯“加一个隐形 buff”。
 鳳 笑夢 Post #27
今日制作的葱炒竹蛏,昨天油麦菜没用完于是又炒了剩下的😗
好清淡热量好低于是迅速煎了半熟蛋补上但还是没吃饱😵
- 无状态垃圾桶 Post #164
@io bug: 在一个 topic 回复过程中浏览到其他 topic,回复会提交到其他 topic 而不是原 topic
也有可能是我困迷糊了 🫠
- 无状态垃圾桶 Post #23
大于 8 byte 的类型赋值到接口类型都会逃逸到堆,产生堆分配
可以使用 go 编译器进行逃逸分析:
go build -gcflags="-m" /path/to/src.gosync.Pool案例分析slice.go- 切片池package heaptest import "sync" var slicePool = sync.Pool{ New: func() any { return make([]byte, 10) }, } func getSlice() []byte { return slicePool.Get().([]byte) } func putSlice(s []byte) { slicePool.Put(s) }./slice.go:7:14: make([]byte, 10) escapes to heap ./slice.go:15:15: leaking param: s ./slice.go:16:16: s escapes to heap这里
slicePool.Put(s)会产生一次堆分配,因为 slice header 有 24 bytes,无法放入接口类型slicePtr.go- 切片指针池package heaptest import "sync" var slicePtrPool = sync.Pool{ New: func() any { b := make([]byte, 10) return &b }, } func getPtrSlice() *[]byte { return slicePtrPool.Get().(*[]byte) } func putPtrSlice(s *[]byte) { slicePtrPool.Put(s) }./slicePtr.go:7:3: moved to heap: b ./slicePtr.go:7:12: make([]byte, 10) escapes to heap ./slicePtr.go:16:18: leaking param: s这样 slice header 和 slice 本身都分配在堆上,Put 时仅储存 slice header 指针(8 byte)
map.go- 表池package heaptest import "sync" var mapPool = sync.Pool{ New: func() any { return make(map[int]int) }, } func getMap() map[int]int { return mapPool.Get().(map[int]int) } func putMap(m map[int]int) { clear(m) mapPool.Put(m) }./map.go:7:14: make(map[int]int) escapes to heap ./map.go:15:13: leaking param: mmap 类型本来就是指向 map 内容的指针,所以可以直接赋值给接口类型无需堆分配
类似的 chan, func() 也是指针所以也可以高效赋值给接口类型 - ZZethes Post #251
https://www.nber.org/system/files/working_papers/w19681/w19681.pdf
这篇名为“Buffett's Alpha”(巴菲特的阿尔法)的论文收录于文件 "w19681.pdf" 中,由 Andrea Frazzini, David Kabiller 和 Lasse H. Pedersen 撰写。该论文通过严谨的实证分析,探讨了沃伦·巴菲特(Warren Buffett)及其公司伯克希尔·哈撒韦(Berkshire Hathaway)长期以来取得卓越投资业绩的真正驱动力。
1. 令人瞩目的历史业绩,但并非“神话”
-
夏普比率(Sharpe Ratio):在1976年至2011年期间,伯克希尔·哈撒韦的夏普比率达到了0.76,在所有拥有30年以上历史的美国股票和共同基金中排名第一。
-
收益与风险:虽然其年化超额收益率高达19.0%(同期整体市场仅为6.1%),但这一高收益也伴随着24.9%的波动率(高于市场15.8%的波动率)。
-
经历严重回撤:巴菲特同样经历过大幅亏损的艰难时期。例如,从1998年6月到2000年2月,伯克希尔的市值下跌了44%,而同期整体股市却上涨了32%。
2. 成功的关键一:低成本杠杆 (Leverage)
-
独特且低成本的资金来源:巴菲特能够获得独特、稳定且低廉的杠杆资金,其中最特殊的是其保险和再保险业务产生的“浮存金”(Insurance Float)。保险浮存金平均占其总负债的36%,且其平均年化资金成本仅为2.2%,比同期的国库券(T-Bill)利率还要低3个百分点以上。
-
杠杆比例估算:研究估计,巴菲特平均使用的杠杆比例约为
1.6 : 1,这在同比例放大了他的风险的同时,也显著提升了他的超额收益。 -
其他杠杆来源:除了浮存金,他获取杠杆的方式还包括高信用评级的债务发行以及加速折旧带来的税收延期支付等。
3. 成功的关键二:选股策略与因子暴露 (Factor Exposures)
-
传统因子的局限:传统的学术因子(如市场、规模、价值和动量因子)无法完全解释巴菲特的业绩,这也是为什么他的成功曾一度被学术界视为谜团或纯粹的个人天赋。
-
青睐安全与高质量股票(BAB & QMJ):论文引入了“对赌贝塔”(Betting-Against-Beta, BAB)和“质量减去垃圾”(Quality-Minus-Junk, QMJ)这两个因子。分析数据表明,巴菲特极度倾向于购买“安全”(低贝塔、低波动风险)、“便宜”(低市净率的价值股)且“高质量”(高利润、业绩稳定且高分红)的公司股票。
-
Alpha(超额收益)的消失:当在统计回归模型中控制了BAB和QMJ等因子后,巴菲特的超额阿尔法收益在统计上变得不显著。这意味着巴菲特的业绩很大程度上可以由“投资于安全、优质和便宜股票通常会跑赢大盘”这一普遍规律来解释。
4. 选股能力 vs. 企业管理能力 (Public vs. Private)
-
资产拆解:论文将伯克希尔的收益分解为公开交易股票投资组合的收益,以及全资拥有的私有公司的收益。在1980年至2011年间,伯克希尔平均有63%的资产是私有企业,37%的资产投资于公开股票。
-
主要技能在于选股:研究发现,其公开交易股票组合的表现(夏普比率为0.69)优于其私有公司组合(夏普比率为0.43)。这表明,巴菲特超群的能力更多地体现在他的选股技巧上,而不是作为CEO对私有企业进行管理的附加值上。私有公司(尤其是保险业务)的一个核心作用是提供稳定的融资,让他能不断对自己的选股策略施加杠杆。
总结
论文 "w19681.pdf" 总结认为,巴菲特的成功既不是靠抛硬币般的运气,也不是依靠不可言说的魔法,而是依靠巧妙利用低成本的小杠杆,并几十年如一日地坚持投资于便宜、安全、高质量股票所获得的回报。他的伟大之处在于早在半个世纪前就认识到了这些投资因子的有效性,找到了获取长期廉价杠杆的方法,并在经历市场周期与剧烈回撤时,能够做到不抛售并坚守其投资原则。
-
 rotartsinimdA Post #3
本楼内容来自某不愿意透露姓名的在某企业工作的师兄/师姐。 正文如下:
Q1:工作几年来,踩过最深的坑是什么?
答:我在基础架构(Infra)相关的团队,这类业务的特点就是代码稍微有点偏差就容易触发告警甚至出线上问题。要说具体的“大坑”倒也没有,但最大的教训(Learning)其实就两条:**不要犯愚蠢的错误,更不要犯重复的错误。**在涉及核心系统的逻辑上,敬畏心和严谨度永远是第一位的。
Q2:工作之中,如何更好地建立信任?
答:建立信任逻辑很简单,但做起来不容易:
- 首先是靠谱,把分内事做到超出预期。很多人做个 60 分就赶着交差了,但能持续交付 80 分以上质量的人,天然就能赢得信任。
- 要有 Ownership(主人翁意识)和独立思考。不要只当个接需求的“工具人”,多想一步“怎么能让这个系统/架构更好”;遇到不合理的需求,敢于带着更好的方案去质疑和讨论,而不是盲目执行。
Q3:怎么看待 Dirty Work(杂活/硬骨头)?如何争取更好的机会?
答:
- 大部分人的职业生涯都是从做 Dirty Work 开始的。把 Dirty Work 做好、做精,是让领导和团队看到你能力、建立初始信任(Trust)的最快途径。
- 有了信任,核心业务和更好的机会自然会优先考虑你。
- 但同时也要保持清醒:如果发现自己已经把杂活做到了极致,却依然看不到任何上升空间或有深度的技术挑战,那就该果断看看外部的新机会了。
Q4:工作之余,如何保持爱好与社交关系?
答:坦白讲我自己在这方面还在探索。不过工作后很多很铁的社交关系,其实就是在项目上“并肩作战”培养出来的“革命友谊”。和志同道合的同事一起在工作之余聚聚餐、出去旅游放松或者发展共同爱好,本身也是很自然且舒适的社交方式。
- rotartsinimdA Post #2
本楼内容来自某不愿透露姓名和背景的师兄/师姐。 正文如下:
香港(港三)PhD 申请分享
分享时间:2026-07-28
适用范围:港大(HKU)、港中文(CUHK)、港科大(HKUST),即通常所说的「港三」
学科视角:以 CS(计算机)为主,其他院系情况可能不同
一、这份分享写给谁
- 主要面向大二同学:这个时间点开始准备,时间上仍然来得及(做出一篇一作论文大约需要一年)。
- 大三及研究生同学也可参考:时间线、导师联系方式、背景要求同样适用,只是准备窗口更紧。
- 分享人背景:本科直博去港科大读 PhD,以下内容基于其自身经历与同实验室、同批申请者的真实 data point。
二、申请时间线
香港 PhD 申请不是 "12 月 1 日才开始" ,而是 "12 月 1 日基本已经结束"。这是最容易被误判的一点。
时间 阶段 要做的事 7—8 月 启动陶瓷 开始广泛联系导师(套磁邮件、约聊) 8—12 月 正式申请期 高频联系导师、面试、推进 offer 9—10 月 拿 offer 大部分正常批 offer 在这个区间发出 12 月 1 日 第一批截止 这是 HKPFS(香港博士研究生奖学金计划) 的截止时间,此时 offer 基本已发完 12 月之后 捡漏期 仍有零星机会,但不能作为主计划 两条录取通道
- 提前批:如果你足够优秀、导师认为你有希望拿到 HKPFS,会走提前批。
- 正常批:8—12 月,offer 在这个窗口内基本发完。
关于 12 月之后的「捡漏」
12 月 1 日之后偶尔还会放出额外的 PhD quota,典型触发原因:
- 导师突然拿到新的 grant / 经费变多;
- 导师手上项目增加、临时需要招人。
但这属于运气成分,绝不能当作主要策略。基本上 12 月之前就已经定局。
拿到 offer 之后
顺利的话,后续就是常规流程:办签证 → 入学 → 正常赴港读书。
三、录取者的真实背景(以 CS 为例)
这两年 CS 方向竞争相当激烈。观察到的申请人大致分为两类,本质是**「学校层次」和「论文产出」之间的互补**:
类型 A:学校好 + 国奖,论文一般
- 例如浙江大学、上海交通大学等。
- 本科直博的话,国奖基本上是必须的。
- 具体案例:实验室有一位上海交大 ACM 班的同学,拿了 2—3 年国奖,本科直博。
- 注意:这类同学的科研并不弱——至少有一篇一作,或者有在投的合作文章,即确实接触过科研。
类型 B:学校一般,但论文很多
- 具体案例:某位同学本科是 211,但有 **4 篇一作,其中 2 篇 TPAMI **。
- 这是相当夸张的产出,用论文数量和质量弥补了学校背景。
归纳出的最低门槛
- 至少一篇一作论文(硬性共识)。
- 只看一作——合作文章(非一作)基本不被认可。
- 有真实的科研经历。
- GPA 保持在较好水平(但主导因素仍是 paper)。
优先级排序:paper > 学校 > GPA
四、如何拿到第一篇一作论文(核心方法论)
这是整个分享中最有操作价值的部分。
问题所在
很多教授并不直接带学生。你直接找到教授,很难从他那里拿到一个可执行的 idea——这是新手最常见的卡点。
推荐路径
第 1 步:以暑研 / visiting 的名义进组
不要空手要 idea,而是申请去做暑期科研或访问学者。
第 2 步:在组里找一位高年级博士生
- 让高年级博士生给你具体的建议和 idea;
- 由他实际指导你的研究推进;
- 最后把通讯作者挂给这位博士生——这是被接受、且很常见的做法。
这样能比较高效地拿到第一篇文章。
第 3 步:第一篇先在本校做
- 直接找香港的组做第一篇,对方大概率不太愿意接收你(你还没有证明过自己)。
- 更现实的做法:先在本校找老师做(例如西交的同学就找西交的老师),在本校找一位靠谱的博士生,从他那里要 idea,产出第一篇。
第 4 步:拿着成果再去香港
- 有了第一篇,就等于有了 improvement,证明了你能干活;
- 这时候再去香港的实验室做 visiting,和港校老师合作发一篇;
- 老师对你建立起信任后,发 offer 就变得水到渠成 / 理所应当。
路径图
本校暑研/visiting
   └─ 高年级博士给 idea + 指导,通讯挂给他
        └─ 产出第一篇一作  →  证明「能干活」
             └─ 去香港实验室 visiting
                  └─ 与港校导师合作再发一篇
                       └─ 建立信任  →  offer
五、行动清单(Checklist)
如果你是大二
- 现在就启动第一篇一作论文的准备(预留约 1 年周期,做完差不多大三)
- 联系本校老师,申请暑研或组内访问
- 在组里锁定一位靠谱的高年级博士生作为实际指导人
- 明确 idea 与分工,通讯作者可挂给指导你的博士
- 同时维持 GPA,争取国奖(尤其如果走本科直博)
如果你已经有一篇一作
- 争取去港校实验室 visiting,与目标导师合作产出第二篇
- 7—8 月开始给港三导师发套磁邮件
- 8—12 月保持高频跟进 + 面试
- 若竞争力强,主动争取走 HKPFS 提前批
六、关键提醒
- 12 月 1 日是终点不是起点——它是 HKPFS 截止日,那时 offer 基本已经发完。
- 只看一作——非一作的合作论文在评估中基本不计入。
- 不要一上来就找港校要 idea——先在本校证明自己,再去港校谈合作。
- 国奖对本科直博近乎刚需(尤其在论文不够突出的情况下)。
- 近两年竞争明显加剧,早开始是唯一确定的优势。
本文基于分享者的口述内容整理,属于个人经验与观察到的样本,具体录取标准以各校官方要求和导师实际情况为准。
 Dvm Post #42
底部导航栏的蓝色进度条有点晃眼
 紫金港第一皮革<・)))><< Post #15
希望可以把原先的badge迁移过来😭
- rotartsinimdA Post #16
我想到了。你快新开一个topic,我将用于整理西交计算机专业或从事计算机相关的校友会信息。
- rotartsinimdA Post #18
- 输入框这里也有bug吧,渲染有延迟(preview)
- 输入框里面快捷键用不了,比如(CTRL+B),感觉不如老版。。。
- 长帖子的数据拉取速度确实慢了很多()
- rotartsinimdA Post #17
但是不同的内容又确实可以归到目前已有的不同topic里。。有点难绷。。
可能需要实现以下几个条件:
- 发布在该类下的内容可以补充到对应的topic里,但是类似于帖子的可见性设置(Linuxdo的等级制度),对应帖子的访问可以设置为仅【verified by xjtu/sjtu/..jtu mail】可见。
- 原本的绑定邮箱【尤其是 jtu 类】的需要恢复。。
- 无状态垃圾桶 Post #448
 玉米🌽 Post #5
支持 😀 换成 murmur 后就贴不了了
- ZZethes Post #246
不可靠叙述者
故事由某个角色讲述,但读者不能完全相信他对事实的描述、解释或判断。
叙述者可能因为以下原因,使叙述发生偏差:
- 故意隐瞒、欺骗
- 自我美化或推卸责任
- 记忆错误
- 年龄太小、理解能力有限
- 精神状态异常
- 受到创伤、酒精或药物影响
- 对自己缺乏认识
- 只掌握局部信息
- 被偏见、嫉妒、情欲或恐惧支配
因此,作品表面上讲的是一个故事,实际上要求读者完成另一项工作:
从叙述者的话语裂缝中,重建可能的真相。
“不可靠”具体表现在哪里
可以把叙述分成三个层面:
1. 事实不可靠
叙述者说某件事发生了,但它可能根本没有发生,或者实际情况与他说的不一样。
例如:
“我只是轻轻推了她一下。”
但通过其他细节,读者逐渐意识到,那可能是一次严重的暴力行为。
2. 解释不可靠
事件本身可能真实,但叙述者对事件的理解存在偏差。
例如:
“她没有回复我的消息,因为她其实还在乎我。”
她确实没有回复,但“因为还在乎”只是叙述者的自我安慰。
3. 道德判断不可靠
叙述者准确讲出了发生的事情,却把明显有问题的行为描述成合理、浪漫或无辜。
例如:
“我只是太爱她,所以才一直跟踪她。”
事实可能是真的,但叙述者对自身行为的道德判断严重失真。
不可靠叙述者不等于“第一人称叙述者”
第一人称天然具有局限性,但不一定不可靠。
“我不知道门外发生了什么”,只是信息有限;
“门外什么都没有发生”,而作品暗示那里发生了重大事件,才可能构成不可靠。关键不是叙述者是否知道一切,而是:
作品是否有意识地让读者发现:叙述者的话与作品暗示的现实之间存在距离。
这个距离通常通过细节矛盾、其他人物反应、语言漏洞、时间线问题或叙述者的自我辩护显现出来。
常见的不可靠叙述者类型
1. 欺骗型
叙述者知道真相,但故意误导读者。
这类作品常见于侦探小说和悬疑故事。叙述者会通过省略、模糊表达或语言技巧隐藏关键事实。
2. 自我欺骗型
叙述者未必在骗读者,而是在骗自己。
他可能把自私解释成牺牲,把控制解释成爱,把懦弱解释成理性。读者逐渐看出,叙述者的自我形象和实际行为并不一致。
3. 天真型
叙述者年幼、单纯,无法理解事件的真实意义。
他说出的事实可能基本准确,但他不知道这些事实意味着什么。读者比叙述者理解得更多。
4. 精神或感知失常型
叙述者受到幻觉、妄想、记忆障碍或极端心理状态影响,无法区分现实与想象。
这类作品常故意让读者处于不确定状态:究竟发生了超自然事件,还是叙述者精神崩溃?
5. 偏见型
叙述者被阶级、性别、种族、嫉妒、爱欲或个人恩怨影响,只能从一种扭曲的角度理解他人。
他未必说假话,但会选择性地注意、描述和评价事实。
经典例子
1. 《罗杰疑案》——阿加莎·克里斯蒂
这是“不可靠叙述者”在侦探小说中最经典的案例之一。
故事由谢泼德医生以第一人称记录。他看起来像传统侦探小说中的助手:冷静、客观、负责记录波洛的调查。
他的不可靠之处不主要是直接说谎,而是:
- 精确选择说什么
- 有意省略某些行动
- 用模糊语言掩盖关键时刻
- 利用读者对“侦探助手”角色的信任
其高明之处在于,叙述者的句子从字面上看未必虚假,但会诱导读者形成错误结论。
这是一种典型的:
语言技术型不可靠叙述。
2. 《洛丽塔》——弗拉基米尔·纳博科夫
亨伯特是最著名的自我美化型叙述者之一。
他语言优美、聪明、幽默,具有极强的修辞能力。他试图把自己的行为包装成悲剧性的爱情,把自己塑造成受激情折磨的浪漫人物。
但读者必须区分:
- 他的语言有多美
- 他的行为实际上是什么
- 被他描述的女孩真正经历了什么
他的危险性就在于,他不是一个表达混乱的叙述者,而是一个表达能力过于强大的叙述者。他试图用文学语言控制读者的同情。
阅读这部作品时,核心问题不是“他说的事实是真是假”,而是:
他的修辞是否正在替他的行为开脱?
这是典型的:
道德判断不可靠 + 自我辩护型叙述。
3. 《长日将尽》——石黑一雄
主人公史蒂文斯是一位英国管家。他的叙述表面上克制、专业、理性,甚至非常诚实。
但随着回忆展开,读者逐渐意识到,他一直在回避一些重要问题:
- 他是否把职业忠诚看得过于绝对
- 他是否错误判断了主人
- 他是否压抑了自己的感情
- 他是否为了维持自我尊严,重新解释了过去
史蒂文斯通常不是故意欺骗读者。他最大的不可靠来自:
他无法诚实面对自己的人生。
他说“这是职业尊严”,读者却可能看到恐惧、情感压抑和自我牺牲;他说自己没有遗憾,叙述本身却充满遗憾。
这是最经典的:
自我欺骗型不可靠叙述者。
4. 《螺丝在拧紧》——亨利·詹姆斯
故事中的女家庭教师声称,自己看见了鬼魂,并相信两个孩子受到了邪恶力量控制。
问题在于,作品始终没有彻底确认:
- 鬼魂真的存在
- 家庭教师产生了幻觉
- 她误解了孩子
- 她的压抑欲望和恐惧影响了判断
叙述者对自己的判断非常确信,但这种确信反而可能增加不安。
作品的经典性就在于,它没有简单告诉读者“她疯了”或“鬼是真的”,而是让两种解释长期并存。
这是典型的:
感知不可靠 + 解释不可靠。
5. 《搏击俱乐部》——恰克·帕拉尼克
叙述者受到严重失眠、身份危机和心理分裂的影响。
他把某些经验理解为外部发生的事件,但随着故事推进,读者发现,他对人物关系和事件因果的理解并不可靠。
这类叙述的特点是:
- 叙述者不是有意识地撒谎
- 读者最初与他共享同一套错误认知
- 当叙述者重新理解现实时,读者也必须重新解释此前的故事
这是典型的:
身份认知失常型不可靠叙述。
6. 《告密心》——埃德加·爱伦·坡
开头时,叙述者急切地强调自己没有疯。
但他越努力证明自己理性,越暴露出:
- 极端偏执
- 感知异常
- 情绪失控
- 对暴力行为的扭曲合理化
这是一个经典技巧:
叙述者的自我证明,反而成为他不可靠的证据。
他认为自己的计划周密、感官敏锐,足以证明自己清醒;读者却从这种过度强调中察觉到精神失常。
7. 《麦田里的守望者》——J. D. 塞林格
霍尔顿并不是悬疑意义上的骗子。他的不可靠来自青春期情绪、创伤、厌恶感和自我矛盾。
他不断说别人“虚伪”,但他自己也会:
- 撒谎
- 表演
- 前后矛盾
- 理想化某些人
- 贬低自己无法接近的人
他的判断不一定完全错误,但高度受到情绪影响。
读者需要同时看到两个霍尔顿:
- 他口中那个愤怒、讽刺、看透世界的自己;
- 一个孤独、悲伤、无法处理失去的少年。
这是典型的:
青春期视角 + 情绪偏差型不可靠叙述。
8. 《了不起的盖茨比》——F. 斯科特·菲茨杰拉德
尼克·卡拉威是否属于严格意义上的不可靠叙述者,文学研究中存在争议,但他经常被列入讨论。
他一开始声称自己不轻易评判别人,实际上整部小说充满判断。他说自己诚实,却明显:
- 选择性地同情盖茨比
- 对某些人物格外苛刻
- 把盖茨比浪漫化
- 在事后重新组织故事意义
尼克未必篡改了主要事实,但他的叙述受到崇拜、厌恶和怀旧影响。
所以他更接近:
价值判断不可靠,而非事实完全不可靠。
9. 《美国精神病人》——布雷特·伊斯顿·埃利斯
帕特里克·贝特曼的叙述充满极端暴力、消费细节、身份混淆和现实断裂。
读者无法确定:
- 暴力行为是否全部真实发生
- 某些场景是否是幻想
- 其他人物是否认错了人
- 整个社会是否根本不在意个人身份
这部作品的不可靠性不仅来自人物心理,还来自作品所描写的世界:人人穿着相似、说着相似的话、互相叫错名字,个体身份不断消失。
因此它是:
精神失常与社会现实共同制造的不可靠。
10. 《罗生门》及“罗生门效应”
严格说,《罗生门》电影中的重点不是单一不可靠叙述者,而是多个彼此冲突的不可靠证词。
同一事件由不同人物讲述,每个人都提供一个有利于自身尊严、利益或自我形象的版本。
这里揭示的是:
人不仅会对别人撒谎,也会通过叙述,把自己改写成能够接受的人。
“罗生门效应”后来常用来描述:不同目击者对同一事件给出互相矛盾、但各自具有主观真实性的说法。
判断不可靠叙述者的几个信号
叙述者反复强调自己可信
例如:
- “我绝对没有疯。”
- “我一向是最诚实的人。”
- “你必须相信我。”
- “我完全没有嫉妒。”
越是不必要地强调,越可能暴露其不安。
语言和行为互相冲突
他说自己不在乎,却花大量篇幅谈论对方;
他说自己无辜,却不断合理化行为;
他说自己非常冷静,语言却越来越混乱。事实与解释不一致
叙述者说大家尊敬他,但其他人物明显害怕或躲避他。
叙述中出现无法解释的空白
包括:
- 记忆断裂
- 时间线错误
- 关键事件被跳过
- 突然转移话题
- 对重要细节极度含糊
叙述者拥有明显的自我辩护动机
例如他正在:
- 接受审判
- 写忏悔录
- 争取读者同情
- 解释一段失败的关系
- 维护自己的名誉
- 证明自己精神正常
- ZZethes Post #248
中国哲学极其强调“诚”与“知行合一”,对于那种只靠嘴皮子、装样子的行为有着极其严厉的批评。
- “巧言令色,鲜矣仁。” ——《论语·学而》
- 释义: 话说得很动听,脸色装得很和善,这种人很少有真正的仁德。
- “听其言而观其行。” ——《论语·公冶长》
- 释义: 孔子说,以前我听人说话就相信他,现在我听了他说的话,还要看他的实际行动。
- “知而不行,只是未知。” —— 王阳明《传习录》
- 释义: 知道了一个道理却没有去践行,那说明你根本没有真正懂这个道理。
西方传统中,从古希腊哲学到基督教神学,再到近代道德哲学,都对“仅仅在修辞上模仿道德”有着深刻的警惕。
在古希腊,有一群人专门教导辩论和修辞,他们不在乎真理,只在乎“听起来有道理”,这群人被苏格拉底和柏拉图严厉批判。
- “修辞术只不过是一种谄媚的技巧(Knack of flattery)。” —— 柏拉图《高尔吉亚篇》
- 释义: 柏拉图认为,修辞学(只追求说服力而不追求真理)就像是糕点制作之于医学——糕点只是让你觉得好吃(谄媚),而医学才是真正治病。修辞学不关心什么是真正的善,只关心如何讨好听众。
圣经对伪善有着最严厉的声讨,核心概念就是“法利赛人”。
- “你们这假冒为善的文士和法利赛人有祸了!因为你们洗净杯盘的外面,里面却盛满了勒索和放荡。” ——《马太福音》23:25
- 释义: 耶稣批评他们只注重外表的洁净和遵守律法的形式,内心却充满肮脏。
- “字句是叫人死,精意是叫人活。”(The letter kills, but the Spirit gives life.) ——《哥林多后书》3:6
- 释义: 死守外在的律法字句会扼杀生命,只有内在的圣灵(真实的精神)才能带来生命。
伊曼努尔·康德(Immanuel Kant)的道德哲学。
-
“行为仅仅‘合乎义务(in conformity with duty)’是不够的,它必须是‘出于义务(from duty)’才有道德价值。” —— 康德《道德形而上学奠基》
- 释义: 康德认为,比如一个商人童叟无欺,如果他只是为了图好名声赚钱,那这只是“合乎义务”,没有道德价值;只有当他认为“诚实是绝对的道德法则”而去这样做时,才是“出于义务”。
-
孔子 称之为**“乡愿”**
-
老子 称之为**“大伪”**
-
王阳明 称之为**“知而不行”**
-
柏拉图 称之为**“谄媚的修辞术”**
-
耶稣 称之为**“洗净外面的杯盘(法利赛人)”**
-
康德 称之为**“仅仅合乎义务”**
- “巧言令色,鲜矣仁。” ——《论语·学而》
- ZZethes Post #245
改掉坏习惯时,真正需要建立的是一个简单、稳定、可重复的行为单元;
过度惩罚和过度补偿却会让整个系统无法运行。任务括号
“任务括号”可以把一个习惯理解成一个被明确起点和终点包住的行为块:
触发信号 → 执行动作 → 明确结束
例如:
〔晚上刷完牙 → 把手机放到客厅 → 上床睡觉〕
大脑不必反复判断“现在该做什么”,只要遇到起点,就运行中间动作,看到结束信号,就关闭任务。
在习惯研究中,动物实验观察到:当一串行为逐渐自动化后,感觉运动纹状体的神经活动会特别强调动作序列的开始和结束,像给整段行为加上括号。这种现象通常被称为“task bracketing”或行为组块化。
过度补偿怎样破坏括号
假设你规定:
今天玩手机超过30分钟,明天就必须学习三小时补回来。
原本需要建立的系统很简单:
〔想刷手机 → 关闭应用 → 去做替代活动 → 结束〕
但加入过度补偿后,它会变成:
〔刷手机超时
→ 判断自己是否失败
→ 计算超时多少
→ 决定补偿多少
→ 安排什么时候补偿
→ 检查补偿是否完成
→ 没完成就继续累积债务
→ 因内疚再次逃避〕此时,你已经不是在处理一个坏习惯,而是在维护一个复杂的“行为债务系统”。
用程序设计来比喻,原来的习惯像一个简单函数:
出现触发点
→ 执行替代动作
→ 返回正常生活
过度补偿却加入了大量异常处理和嵌套条件:
出现触发点
→ 是否失败?
   → 失败多少?
      → 惩罚多少?
         → 今天执行还是明天执行?
            → 没执行是否加倍?
规则越多,系统越容易在疲劳、压力大或情绪低落时崩溃。
为什么容易导致彻底放弃
1. 行为没有明确的结束点
一次失误本来几分钟就可以结束。但如果失误会形成“债务”,事情就不再结束:
今天少学习一小时,明天补两小时;
明天没补完,后天再加倍。任务括号无法闭合。大脑会持续感到“我还有东西没有还完”,从而产生逃避。
2. 每次开始都意味着不可预测的巨大成本
如果一次偏离可能导致禁手机三天、跑步十公里、熬夜补工作,大脑会逐渐把整个改变计划识别为威胁。
最后,人不仅逃避坏习惯的管理,也逃避记录、复盘和重新开始。
3. 惩罚的副作用
惩罚可能暂时压制一个行为,但它未必教会你:
- 出现冲动时具体做什么;
- 怎样改变环境;
- 怎样获得替代奖励;
- 失误后怎样迅速恢复。
因此,原有坏习惯仍然存在,只是外面多包了一层恐惧和内疚。
4. 一次偏离被解释为整个计划失败
常见思维是:
“既然我已经破戒了,今天就彻底算了。”
复发预防研究把这种由一次偏离引发的自责、失控感和进一步复发称为“戒断违背效应”。二元化地看待成功与失败,会使一次小偏离更容易扩大为持续复发。
过度惩罚正是在强化这种二元结构:
完美执行=好;
出现失误=必须受罚。5. 补偿行为可能反过来强化坏习惯
例如:
“今晚可以多玩一小时,反正明天多学两小时。”
大脑学到的新循环可能是:
放纵 → 内疚 → 补偿 → 感觉已经还清 → 再次放纵。
看似在反对坏习惯,实际上建立了一个更大的复合习惯。
习惯系统彻底崩塌
不是说神经系统真的突然坏掉,而是说你的行为方案同时出现了几个问题:
- 规则太多,记不住;
- 补偿债务不断累积;
- 每次行动成本越来越高;
- 一次失误就否定整个计划;
- 自我效能感下降;
- 最终连最小动作也不愿意开始。
最后人通常不是选择更严格地执行,而是把整套规则全部丢掉:
“太麻烦了,我不管了。”
这就是系统性崩塌。
更好的做法:小纠偏,立即闭环,不追债
有效的恢复结构应当是:
〔发现偏离 → 立即停止 → 做一个最小纠正动作 → 恢复原计划 → 结束〕
例如,晚上刷手机超时了。
错误方式:
明天完全禁用手机,并额外学习三小时。
更稳定的方式:
现在关闭应用,把手机放到另一个房间,记录触发原因,然后睡觉。明天仍按原来的30分钟上限执行,不加倍、不追债。
关键原则是:
错误只修复行为本身,不惩罚人,也不把今天的错误转移到明天。
这不等于完全没有后果。可以设置轻微、固定、事先确定并与问题直接相关的纠正措施,例如超时后立即关闭应用、退出账号、开启屏幕限制,而不是临时决定一个情绪化的大惩罚。
[1]: https://www.science.org/doi/pdf/10.1126/science.286.5445.1745 "Building Neural Representations of Habits - Science"
[2]: Relapse prevention for addictive behaviors "Relapse prevention for addictive behaviors - PMC" - 紫金港第一皮革<・)))><< Post #32
不知道能不能实现打开一个阅读过的话题时 进度条在上次阅读的位置而不是首条帖子(有时候翻起来有点麻烦)
- 紫金港第一皮革<・)))><< Post #179
鸭绿江边
抗美援朝纪念馆
🐖到了很好吃的土豆脊骨汤 可惜一直到吃完都没想起拍照🤣
- rotartsinimdA Post #9
问题一:可行。完全可行。计算机是准入门槛最低的专业,没有之一。通过网上一大堆所谓的本科文科,水硕计算机就算转码成功的例子可以佐证。至于考到什么档次的学校,取决于个人的做题水平以及运气,后者可能影响更大。我个人认为虾饺考研应当要么本校,要么遥遥领先本校的学校,其他相差不大的9毫无意义。
问题二:区别不大,实践中约等于0,专硕学费更贵一些,毕业要求更简单。例如虾饺有的专硕有个专利就能毕业。
补充一点:
要不要转计算机相关专业和转码并不完全一致。我认识很多虾饺传统工科出身最后去互联网大厂写代码的。还是要对自己的学历有信心,重点是自己的简历怎么写。  Raccoonbk Post #1
rt。想问问这个上面XJTU和SJTU的uu们都有吗?
祝愉快! 😀 Post #545
南京大学体验
去了鼓楼校区,有一些体验,记一下。主要都是和交大不一样的地方。
网络
南京大学的网络居然是要收费的!
价格:
教学楼内连接无线网的测速结果:
南大的大教室
估计250的教室居然有10个悬挂屏幕!
但是教室里面只有靠墙的部分位置有插座,很不方便。南大是有分区的
鼓楼校区分了南区和北区。南区是生活区,包含宿舍食堂教超等。北区是教学区。两个区域是不连通的进出都需要刷校园卡。
似乎复旦也是如此的。没有全校统一的canvas!
看上去每个学院会单独组织自己的课程信息。比如软件学院的教学网站是
selearning.nju.edu.cn。也没有统一的回放可以看,而是由老师自行上传课程视频回放。
这些在交大都是由canvas实现的。食堂菜种类很多
部分菜是可以称重计费。价格小于等于上海吧。
校内信息化服务是外包的
比如问卷系统是腾讯云
授课质量似乎高于交大大部分老师
这可能是不准确的,但我确实觉得我上的课老师讲得很好,还准备了交互的html来授课,很清楚啊。而且感觉这个理论课老师
课程的一些好玩的东西,类笔记
- agent部分伪代码 本来想上传的但这里无法上传html于是不传了。
- 指令模型在提示词末尾加一句think step by step 会更强。
- lost in the middle: 实际上完整的上下文的头和尾会更关注,中间实际上并没有那么关注。与transformer的自注意力机制有关。
- step back:回答前让他先想更高维的东西,比如执行原则是什么?等等再做具体的事情。
 小西从小就很可爱 Post #79
大伙最近怎么样?感觉科技一直抽血,难绷,就逼着你去科技接盘呗
- 玉米🌽 Post #226
毕业倒计时9天(20260615)
p1、p2:昨天沪上阿姨有杨枝甘露买一送一(可寄存)活动,我一看,相当于 5 折嘛,买了!等今天我想提出来寄存的那杯,突然发现被小程序制裁了。😡
我花了大约 30 min,据理力争讨回了失落的 20 r。午饭吃熊麻婆的炒饭➕杨枝甘露冰沙,美滋滋。🥰
p3、p4:晚上和球友约了球,所以吃清淡点。这应该是本科期间最后几场球了。😔
p5:打完球在浴室门口遇见了卖麒麟瓜的大爷,遂买 1/4 个瓜🍉解渴,这应该是我今年吃到的第一口瓜。
p6:在宿舍一楼遇到的小熊。🐻可爱捏,但是买不起。🥲
p7:网图,被价格吓晕。😵